1. 논문·저자·공모전
| 항목 | 내용 |
|---|---|
| 제목 | AI에게 판단을 맡기는 시대, 준비된 청년은 따로 있다 |
| 부제 | 청년층 AI 판단권 이양 전망과 책임 있는 AI 리터러시의 계층 격차에 대한 LASSO·위계 회귀 교차 확인과 다층 지원 방안 |
| 영문 제목 | Not Everyone Is Ready for the Age of Delegating Judgment to AI: LASSO and Hierarchical Regression Evidence on Class Gaps in Korean Youth's Expectations of Ceding Judgment to AI and Responsible AI Literacy |
| 저자 | 이현진 (숭실대학교 교육경영학과 박사과정 수료) |
| 공모전 | 2026년 AI·디지털 논문공모전 (과학기술정보통신부 주최, 정보통신산업진흥원·한국정보방송통신대연합 주관) |
| 대주제·트랙 | 인간 중심 AI 사회 구현 — 인간존엄 |
| 일정 | 2026년 9월 제출, 심사 결과 10월 말, 시상 11월(예정) |
| 자료 | 한국교육고용패널조사Ⅱ(KEEP II) 1~8차 공개 원자료 (한국직업능력연구원) |
| 주제어 | 인공지능 판단권, 인간 개입, 인공지능 리터러시, 계층 격차, 한국교육고용패널조사Ⅱ |
| Keywords | AI judgment rights, human-in-the-loop, AI literacy, class gaps, Korean Education and Employment Panel II |
한 줄 요약: 인공지능이 사람의 판단을 대신하리라는 전망의 계층 총연관은 작고 역방향인 반면, 그 전제가 되는 인공지능의 한계·윤리·법적 책임에 대한 인지는 계층과 교육 위치를 따라 갈립니다.
2. 연구문제 4개와 답
- 연구문제 1. 청년층의 인공지능 판단권 이양 전망은 어떻게 분포하며, 가정 배경·고교 시기 특성·대학·인공지능 이용 경험 가운데 무엇과 연관되는가?
- 연구문제 2. 책임 있는 인공지능 리터러시와 인공지능 사용 경험은 어떤 계층 격차를 보이는가?
- 연구문제 3. 7차 시점의 판단권 이양 전망은 8차 시점의 리터러시와 사용으로 이어지는가?
- 연구문제 4. 두 결과가 가리키는 집단을 위해 교육 현장·기업·정부는 각각 무엇을 해야 하는가?
연구문제별 답(논문 4장·5장 요약)
- RQ1: 청년 셋 중 둘(64.2%)이 동의했습니다. 부모 학력 표준편차 1당 동의 OR은 .907로 작고 역방향이며, 종속변수를 포함한 다중대체(m=20)에서 부모 학력 계수는 M1 −.051에서 고교 시기를 넣으면 −.023, 최종 −.016이 됩니다. 이 감소는 격차의 부재가 아니라 고교 시기를 통한 매개일 수 있습니다. 전망과 함께 움직인 것은 같은 시점의 위험 인식과 이용 유형이었습니다(M4 ΔR² .2406).
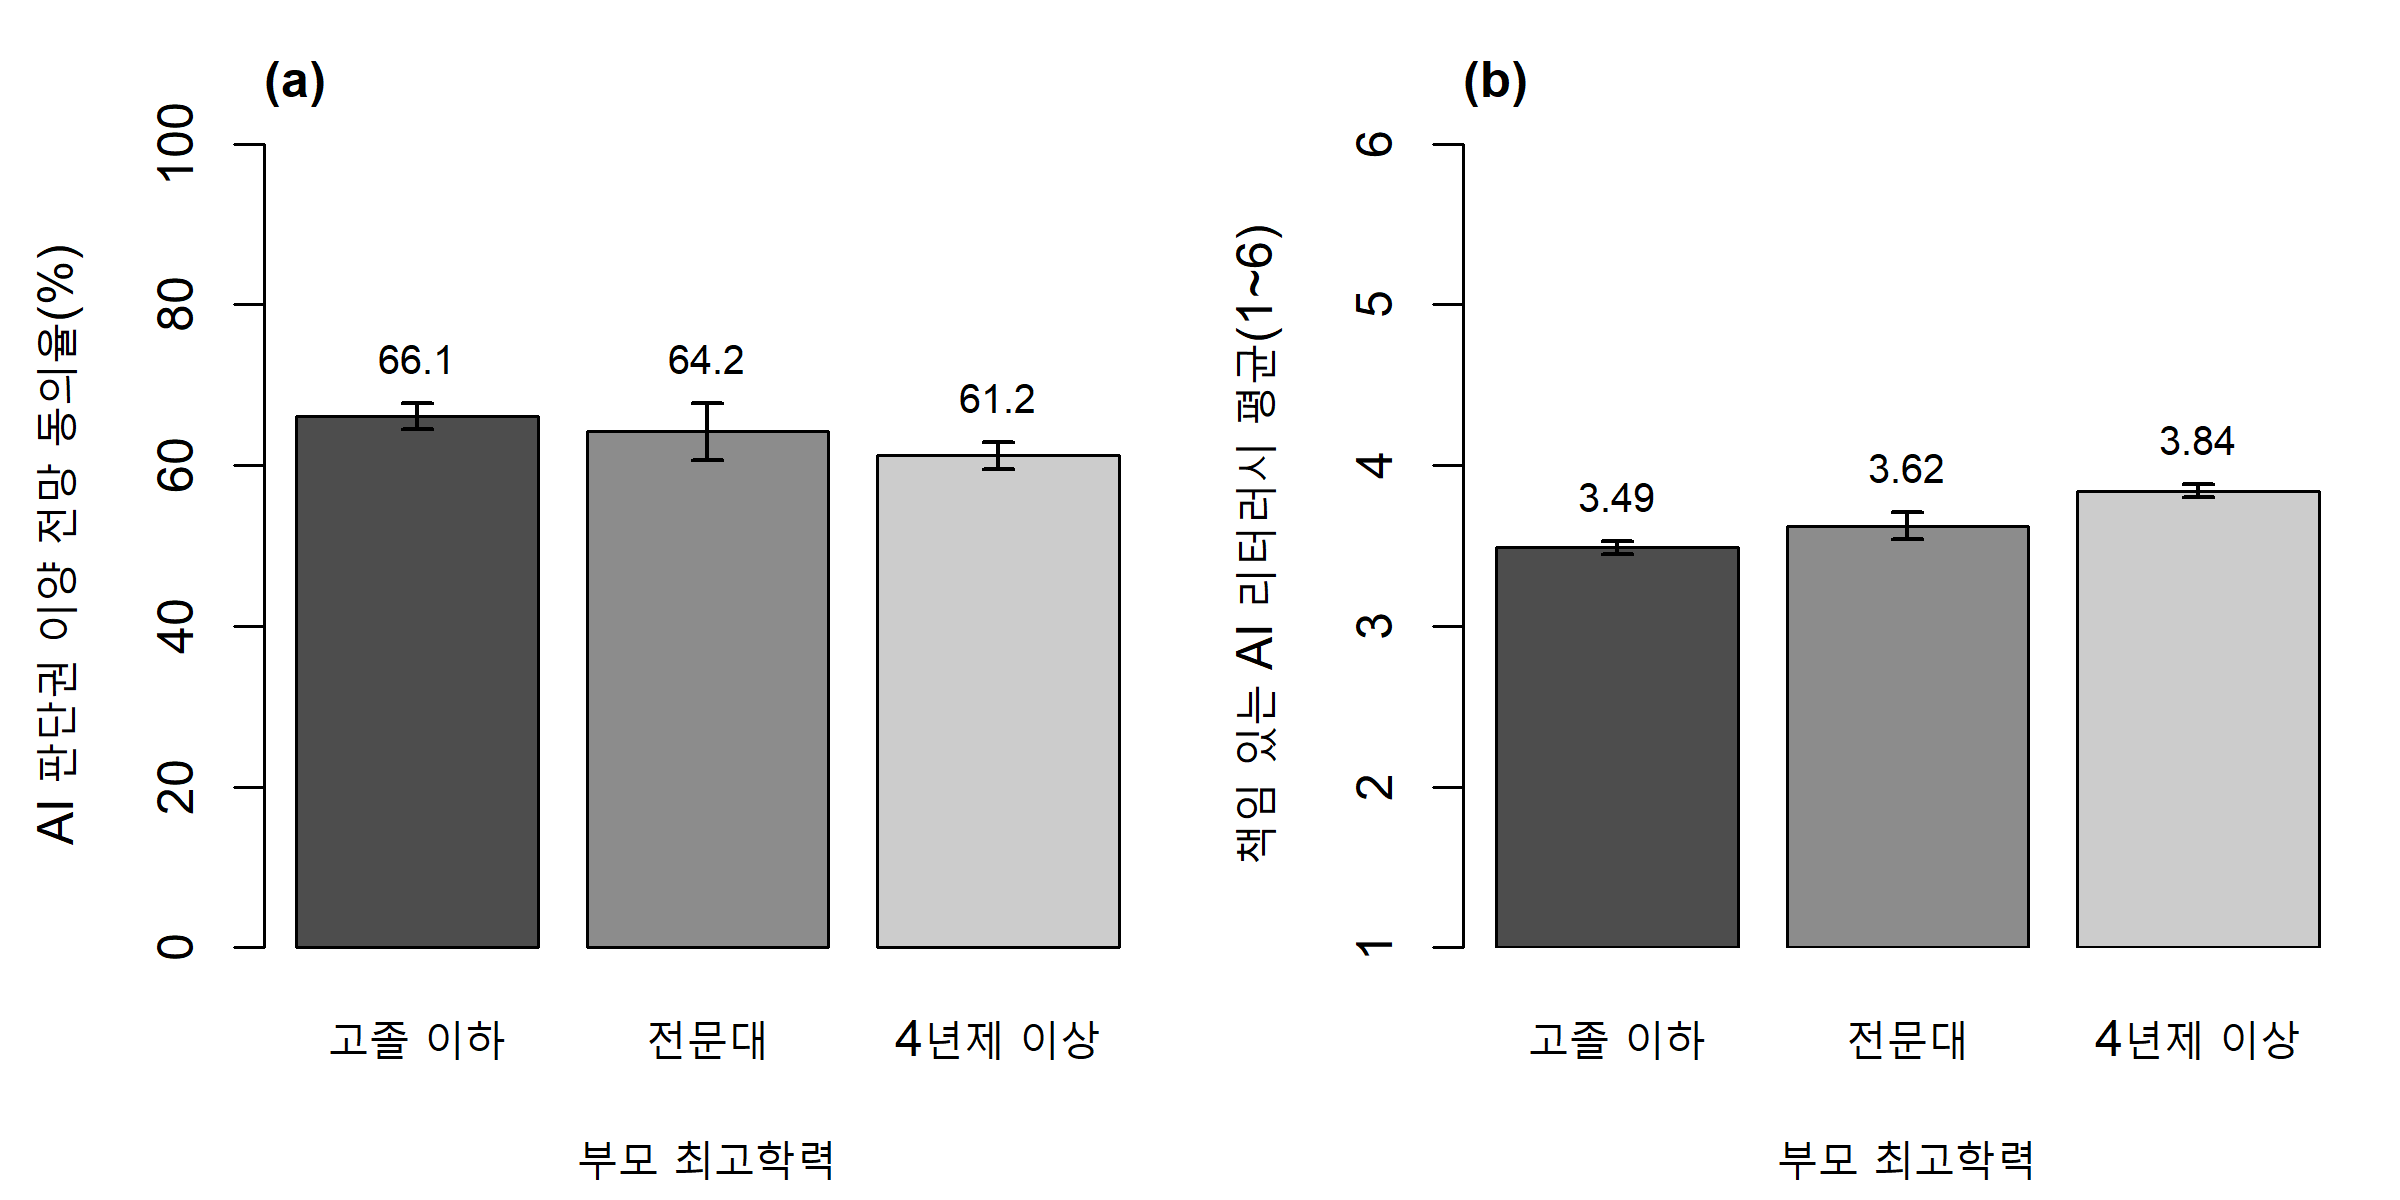
- RQ2: 리터러시는 부모 학력별 3.49, 3.62, 3.84, 대학 유형별 3.34, 3.44, 3.85로 갈렸고, 앱 사용률도 부모 학력별 34.3, 42.4, 44.7%입니다. m=20에서 부모 학력 계수는 .136에서 .054까지 전 단계가 유의합니다. 다만 모든 변수를 통제한 뒤의 고유 기여는 탐색적입니다.
- RQ3: 7차 전망은 8차 리터러시와 유의한 연관이 없었고(β=−0.020, p=.148), 이변량 상관도 −.045입니다. 앱 사용과는 작은 부적 연관(OR 0.900)만 남았으며, 이것은 시간 순서나 방향을 뜻하지 않습니다.
- RQ4: 제언의 표적은 행정 자료로 식별되는 비진학·전문대 진학 청년과 저학력 가정 청년입니다. 교육 현장·기업·정부의 세 층으로 나누어 제시하고, 실증이 뒷받침하는 부분과 법령 해석을 구분합니다(「정책 제언」 탭).
3. 핵심 수치
| 구분 | 값 | 출처 |
|---|---|---|
| 판단권 이양 전망 표본 | 7차 7,742명, 평균 3.78(SD 1.27) | 〈표 1〉 |
| 전망 동의(4점 이상) | 64.2% (5점 이상 31.2%) | 〈표 1〉, 4장 1) |
| 리터러시 표본 | 8차 7,507명, 평균 3.65(SD 1.17), α=.914 | 〈표 1〉 |
| AI 앱 사용 경험 | 39.2% (2,951명) | 〈표 1〉 |
| 집락 | 416개교, 비가중 | 3장 1) |
| 잔존율 | 1차 10,558명 중 7차 판단권 응답 7,742명 = 73.3% | 3장 1) |
| 전망 동의 OR(부모 학력 +1SD) | 0.907 [0.859, 0.957], Bonferroni 통과 | 〈표 5〉 |
| 리터러시 상위 34.6% OR(부모 학력 +1SD) | 1.280 [1.207, 1.356] | 〈표 5〉 |
| 리터러시 평균 β(부모 학력 +1SD) | 0.168 [0.135, 0.202] | 〈표 5〉 |
| 앱 사용 OR(부모 학력 +1SD) | 1.265 [1.196, 1.338] | 〈표 5〉 |
| 두 기울기 | 전망 −.049, 리터러시 .153, 절댓값 차이 .104 [.065, .140] (N=6,728, 부트스트랩 400회) | 4장 4) |
| 리터러시 평균(부모 학력별) | 3.49 / 3.62 / 3.84 | 〈표 2〉 |
| 리터러시 평균(대학 유형별) | 미진학 3.34 / 전문대 3.44 / 4년제 3.85 | 〈표 2〉 |
| 앱 사용률(부모 학력별) | 34.3 / 42.4 / 44.7% | 〈표 2〉 |
| 전망 동의율(부모 학력별) | 66.1 / 64.2 / 61.2% | 〈표 2〉 |
| 판단권 위계 회귀 | M1~M3 R² .0180, M4 ΔR² .2406, 검증 표본 R² .2514 | 〈표 3〉 |
| 리터러시 위계 회귀 | M1 .0321 / M2 .0618 / M3a .0107 / M3b .0289 / M4 .0185, 검증 표본 R² .1382 | 〈표 4〉 |
| 교차 확인 핵심 변수 | 판단권 10개(모두 7차 AI 문항군, 계층 변수 0) / 리터러시 9개 | 〈표 3〉·〈표 4〉 주 |
| 리터러시 BH 통과 | 검증 p<.05 14개 중 2개(일자리 출현 기대·번역 이용, q=.024) | 4장 3) |
| 7차 전망 × 8차 리터러시 | r=−.045 [−.068, −.022], N=7,247 | 5장 1) |
| 리터러시 중간점 미만 | 41.3% | 5장 1) |
해석 요지: 판단권 이양 전망에 대한 동의는 계층을 가로질러 넓게 분포하고, 그 전망을 역량으로 옮길 인지는 계층과 교육 위치에 따라 갈립니다. 계층과 연관되는 지점은 위험을 어떻게 보느냐가 아니라 그 위험에 대해 무엇을 알고 있느냐였습니다.
4. 결론 요약 (논문 5장 6))
- 판단권 전망의 계층 총연관은 작고 역방향(OR .907/표준편차)이고, 인지는 계층과 교육 위치를 따라 갈립니다(OR 1.280, 기울기 절댓값 차이 .104의 95% 신뢰구간 [.065, .140]).
- 개인정보 보호법 제37조의2의 청구권을 행사하려면 결정이 자동화되었음을 알고 근거를 따져 물을 수 있어야 합니다. 본 연구가 잰 것은 그 전제가 되는 자기보고 인지까지입니다.
- 법령을 고치지 않고 착수할 수 있는 제언은 셋입니다. 시행령 제1조의2 제10호의 인정 기준 마련, 실태조사에 판단권 인식·책임 인지 문항군 추가, 법 제34조 제1항 제6호에 따른 감독자 역량 요건·개입 권한 추가입니다.
- 개정이 필요한 것도 셋입니다. 제1조의2 본문의 정의 축을 이용 역량으로 넓히기, 제2조 제4호 카목에 진로·학습 경로 추천 더하기, 시행령 제27조 제4항의 개발사업자 자료 협력을 교육 분야에 한해 의무로 올리기입니다.
5. 서술 규율
- 결과는 연관의 기술이지 인과 추정이 아닙니다. 본문은 "예측한다"와 "연관된다"를 씁니다.
- 판단권 문항은 "10년 후 미래에 AI가 가져올 부정적 영향"을 묻는 문항군의 셋째로, 개인의 위임 의향이 아닌 3인칭 전망에 대한 동의입니다.
- 리터러시의 계층 격차는 두 층으로 읽습니다. 분포·표준화 추정치·생존율·단계별 설명량은 견고하고, 모든 변수를 통제한 뒤의 고유 기여는 탐색적입니다.
- 계층은 출신 배경(부모 학력·아버지 소득), 교육·직무 위치는 본인이 도달한 자리(대학 유형·계열·소재지, 재직·디지털 강도)를 가리킵니다.
- 전망×리터러시 4유형(27.5%)은 표적을 좁히지 못하며, 전망이 역량으로 이어지지 않음을 보이는 기술 장치로만 씁니다.
더 보기
논문 5장 2)~4)의 교육 현장·기업·정부 제언을 카드로 옮겼습니다. 원고는 "각 제안에서 분석 결과가 뒷받침하는 부분과 제도 개선을 위한 해석을 구분한다"고 밝혔으므로, 카드마다 근거의 종류를 표시합니다. 조문 표기는 논문 정본 그대로입니다.
표적과 근거 구분
- 표적: 본 연구가 특정한 집단은 인공지능의 한계·윤리·법적 책임에 대한 인지가 낮은 청년입니다. 여섯 점 자기평정 척도는 개인 급부의 자격 기준이 될 수 없으므로, 제언의 표적은 학적·고용 자료로 식별되는 비진학·전문대 진학 청년(특성화고 졸업 후 미진학 포함)과 저학력 가정 청년으로 적고, 리터러시 축은 그 근거로만 씁니다.
- 근거 표시: 「실증 결과」는 본 연구의 KEEP II 분석이 직접 뒷받침하는 부분, 「법령 검토」는 조문 해석·대조에서 나온 부분, 「정책 검토」는 정부 자료·통계 검토에서 나온 부분, 「선행연구」는 인용 문헌에 기댄 부분입니다.
교육 현장 층
1. 초·중등 인공지능 교육의 내용을 넓힌다
실증 결과법령 검토
제안초·중등 인공지능 교육에 산출물이 틀릴 수 있다는 사실, 결과를 사람이 되돌릴 통로, 이용자가 지는 책임의 범위를 넣습니다.
근거리터러시와 앱 사용이 모두 부모 학력을 따라 갈리고(〈표 5〉) 법적 책임 인지가 세 문항 중 가장 낮습니다(3.45). 이 내용이 유럽연합 인공지능법 제14조 제4항의 세 요구와 같고 인공지능 기본법 제6조 제2항 제6호의2가 정한 교육의 구체적 내용이 될 수 있다는 것은 법령 해석입니다.
2. 인공지능 중점학교 점검표에 윤리원칙을 옮긴다
정책 검토
제안『교육분야 인공지능 윤리원칙』 항목을 중점학교 점검표로 옮기고, 그 결과를 3년 뒤 확대 여부의 근거로 삼습니다.
근거교육 자리는 실증이 아니라 현행 정책 검토로 정합니다. 교육부는 2022년 윤리원칙을 확정했으나 확인한 범위에서 이행 점검 지표가 없고, 2026년 3월부터 중점학교 1,141개교를 3년간 운영하며 특별교부금 385억 원을 배정했으나 공식 과제 네 가지에 윤리도 판단권도 없습니다.
3. 학습지원 소프트웨어 선정기준에 두 항목을 더한다
정책 검토법령 검토
제안학습 상태를 자동 진단하거나 학습 경로를 추천하는 소프트웨어가 산출물 근거를 교사에게 제시하는지, 교사가 그 결과를 뒤집을 수 있는지를 선택기준에 더합니다.
근거교육자료 선정은 초·중등 교육법 제29조의2에 따라 교육부장관의 기준과 학교운영위원회 심의를 거칩니다. 교육부(2025.12.30.) 선정기준은 개인정보 보호 필수기준과 선택기준 다섯 항목(교육목표·학생 특성 적합성, 콘텐츠 품질·안전성, 사용 환경 적합성, 접근성·사용성, 서비스 운영·지원 체계)으로 짜여 있어 두 항목이 없습니다.
4. 학교 밖 학습에도 원칙 수준의 지침을 둔다
정책 검토법령 검토
제안제34조 제1항 제4호의 관리·감독 취지를 이용자 쪽으로 옮겨, 사람이 정답과 허용 범위를 정하고 학습자가 산출물을 검증하도록 하며 책임 주체를 밝히는 원칙 수준의 지침을 둡니다.
근거2025년 사교육 참여율은 75.7%, 총액은 27조 5,000억 원이나 이 통계가 뒷받침하는 것은 필요성까지입니다. 학원의 인공지능 이용에서 사람이 판단하고 검증할 지점을 정한 지침은 확인되지 않으며, 디지털 권리장전 제14조도 학교 안팎을 가르지 않습니다. 원고는 이것이 학원 현장의 실태와 효과를 직접 검증한 결과가 아니라 법령·정책 검토에 기초한 예방적 제안이라고 밝힙니다.
5. 표적 집단을 위한 별도 과정을 둔다
실증 결과
제안비진학·전문대 진학 청년과 저학력 가정 청년을 위한 별도 과정을 둡니다.
근거리터러시는 부모 학력별 3.49, 3.62, 3.84, 대학 유형별 3.34, 3.44, 3.85로 갈립니다. 보편 지원만으로는 역량이 높은 쪽이 더 가져가므로 별도 과정이 필요하다는 것이 원고의 판단입니다.
기업 층
1. 감독자의 역량 요건과 개입 권한을 사업자 책무에 더한다
법령 검토
제안제34조 제1항 제4호의 "사람의 관리·감독"에 감독자의 역량 요건과 개입 권한을 추가합니다.
근거제34조 제1항 제4호와 시행령 제27조 제1항 제4호는 관리·감독과 담당자 정보 공개를 규정하지만 역량 요건과 개입 절차는 명시하지 않아 유럽연합 인공지능법 제14조 제4항의 세 요구와 대비됩니다. 제34조 제1항 제6호가 "위원회에서 심의·의결된 사항"을 책무로 추가할 수 있게 열어 두어 추가 자체는 국가인공지능전략위원회 의결만으로 가능합니다. 다만 게시·보관 등 이행 방식에는 시행령 제27조의 보완이 따릅니다.
2. 자동화된 결정의 고지 형식을 이용자 조건에 맞춘다
실증 결과법령 검토
제안주된 이용자의 나이와 사회적 조건을 고려하라는 원칙을 사전 고지와 생성물 표시까지 넓힙니다.
근거개인정보 보호법 제37조의2 제4항은 자동화된 결정의 기준과 절차를 쉽게 확인하도록 공개하라고 정했고 방법은 같은 법 시행령 제44조의4가 규율합니다. 공개 형식을 바꿀 필요는 법적 책임 인지가 가장 낮고 부모 학력에 따라 갈린다는 4장의 결과가 뒷받침합니다. 인공지능 기본법 시행령 제23조 제3항 제2호의 고려 원칙은 가상 결과물에만 적용되므로, 이를 같은 조 제1항·제2항까지 넓히자는 것은 법령 해석에 따른 제안입니다.
3. 설명 방안을 공개한 사업자에게 양방향 유인을 준다
선행연구법령 검토
제안설명 방안과 감독자 접근 경로를 공개한 교육 분야 사업자에게 자율 인증 표시를 주고, 공공 조달과 학교·학원 선정 기준에 반영합니다.
근거직접 제재가 없는 조문을 보완할 유인 구조입니다. 이준혁 외(2025)에서 투명성은 신뢰와 수용의 관계를 강화하므로 충실한 설명은 사업자에게도 이익이 됩니다.
4. 책임이 갈라지는 두 지점을 메운다
법령 검토
제안해당성 확인 요청에 자율 인증 표시를 연계하고, 시행령 제27조 제4항의 개발사업자 자료 협력을 교육 분야에 한해서라도 의무로 올립니다.
근거제33조 제1항은 사전 검토는 의무로, 장관 확인 요청은 임의로 두어 해당성 판단의 1차 주체가 사업자 자신이 됩니다. 시행령 제27조 제3항은 개발사업자가 조치를 이행하면 이용사업자도 이행한 것으로 보면서, 개발사업자의 자료 협력은 제4항의 노력 의무로만 둡니다. 이용사업자인 학교와 학원은 설명 자료 없이 교사에게 판단을 맡기게 되어 책임 전가가 되풀이됩니다(김준서, 2026, 97).
정부 층
1. 감독이 실질이 될 최소 조건을 고시로 정한다
법령 검토선행연구
제안제34조 제2항에 따라 감독자의 역량 요건과 개입 절차의 최소 조건을 고시로 제시합니다.
근거제34조 제2항은 장관이 "제1항 각 호에 따른 조치의 구체적인 사항을 정하여 고시하고, 인공지능사업자에게 이를 준수하도록 권고할 수 있다"라고 정했습니다. 그 고시의 구속력은 권고에 그칩니다. 출발점은 황지은(2020, 48)의 세 기준, 곧 검토자의 이해, 실제 검토 행위, 근거 설명 가능성입니다.
2. 인공지능 취약계층의 인정 기준을 마련하거나 정의 축을 넓힌다
실증 결과법령 검토
제안해석론으로는 시행령 제1조의2 제10호의 인정 기준을 마련해, 중앙행정기관의 장과 지방자치단체의 장이 학적·고용 상태 같은 행정 자료로 범주를 확인해 적용하게 합니다. 개정론으로는 제1조의2 본문의 정의 축을 접근에서 이용 역량으로 넓힙니다. 두 방안을 함께 제안합니다.
근거제1조의2 본문은 취약계층을 "인공지능제품 또는 인공지능서비스의 이용에 어려움을 겪는 장애인·고령자 등"으로 한정하고, 제10호도 "이용에 어려움을 겪는 사람"으로 같은 요건을 되풀이합니다. 그러나 본 연구가 특정한 집단은 접근이 막힌 사람들이 아닙니다. 미진학 29.8%, 전문대 31.1%가 이미 앱을 써 보았습니다. 산출물의 근거를 따져 묻지도 이의를 제기하지도 못한 채 쓰는 상태를 책임 있는 이용의 어려움으로 포섭하는 해석은 제1조와 제3조 제5항의 취지에 기댑니다. 배경만으로 자동 지정되지는 않으며, 자기평정 점수를 개인별 자격 기준으로 쓰지 않습니다. 이용 비용 지원까지 열려면 시행령 제15조의2 제1항 제5호를 함께 써야 하나, 그 요건은 "경제적 여건으로 이용이 어려워" 인정하는 사람이어서 다릅니다.
3. 보장 영역의 빈칸을 채운다
법령 검토
제안제2조 제4호 카목의 위임을 받아 진로·학습 경로 추천을 고영향 영역에 더하는 방안을 검토하고, 보장 영역은 생명과 해악이 걸린 판단부터 법정화합니다.
근거카목은 고영향 영역 추가를 대통령령에 위임했으나 받은 규정이 없어, 학생 평가(차목)와 채용 판단(사목) 사이의 진로·학습 경로 추천이 어느 목에도 없습니다. 카목에는 "사람의 생명·신체의 안전 및 기본권 보호에 중대한 영향을 미치는 영역으로서"라는 실질 요건이 있어, 추가하려면 그 추천이 기회 배분에 미치는 영향을 자료로 보여야 합니다. 원고는 본 연구의 계층 격차 결과가 그 직접 근거가 아니라고 밝힙니다.
4. 실태조사에 판단권 인식과 책임 인지 문항을 넣는다
실증 결과법령 검토
제안법령을 고치지 않고 실태조사에 판단권 인식과 책임 인지 문항군을 넣고, 계층 구분을 같은 연령대 안까지 내립니다.
근거청년 내부 격차가 확인되었습니다. 디지털 정보격차 실태조사는 20대의 디지털정보화 수준을 124.3%로 집계해 청년을 격차 없는 집단으로 다루고, 제38조의 실태조사도 시행령 제30조 제1항 제1호부터 제8호까지가 산업 지표입니다. 같은 항 제9호의 포괄 조항과 설문조사를 명시한 제2항이 근거가 됩니다.
5. 집행력의 공백을 메운다
법령 검토
제안사업자 책무 조항의 이행 점검 절차를 둡니다.
근거제43조의 과태료는 사업자 책무 위반 가운데 제31조 제1항의 사전 고지 위반에만 붙습니다. 제34조 제1항 위반에는 제40조 제3항의 중지·시정명령을 거치는 간접 경로가 있으나, 제35조는 그 조항이 열거한 대상에 없어 간접 경로조차 없습니다. 이행 점검 절차가 없으면 제안은 권고에 머뭅니다.
6. 계획과 원칙에 전달 경로를 붙인다
실증 결과법령 검토
제안차기 기본계획에 국민 대상 인공지능 교육의 이행 지표를 넣되, 지표를 이수 인원이 아니라 계층별 역량 격차의 축소 폭으로 잡습니다. 판단 유보 교육을 윤리 실천방안에 담습니다.
근거제6조 제2항 제6호의2가 인공지능 교육을 기본계획의 법정 포함사항으로 둡니다. 지표를 격차 축소 폭으로 잡아야 하는 근거는 4장의 격차 결과입니다. 제27조 제1항은 윤리원칙 제정을 재량으로, 제2항만 실천방안 수립·공개를 의무로 두었으므로 입법 없이 전달 경로가 생깁니다.
결론의 제언 목록 (논문 5장 6))
법령을 고치지 않고 착수할 수 있는 셋
법령 검토
제안① 시행령 제1조의2 제10호의 인정 기준을 마련해 비진학·전문대 진학 청년과 저학력 가정 청년을 인공지능 취약계층에 넣는 일 ② 제30조 제1항 제9호와 제2항을 근거로 실태조사에 판단권 인식·책임 인지 문항군을 넣고 계층 구분을 같은 연령대 안까지 내리는 일 ③ 법 제34조 제1항 제6호에 따라 위원회 의결만으로 감독자의 역량 요건과 개입 권한을 책무에 더하는 일.
근거마지막 항목의 게시·보관 등 이행 방식에는 시행령 제27조의 보완이 따릅니다.
개정이 필요한 셋
법령 검토
제안① 제1조의2 본문의 정의 축을 이용 역량으로 넓히는 일 ② 제2조 제4호 카목에 진로·학습 경로 추천을 더하는 일 ③ 시행령 제27조 제4항의 개발사업자 자료 협력을 교육 분야에 한해 의무로 올리는 일.
근거조문 분석에 근거한 개정 제안입니다.
논문 3장을 12개 절로 풀었습니다. 제목을 누르면 펼쳐집니다. 각 절은 쉬운 설명, 정의와 수식, 이 논문에서, 출처 순입니다.
1. 자료·표본·탈락
쉬운 설명
한국교육고용패널조사Ⅱ(KEEP II)는 2016년 고등학교 2학년이던 한 학년 집단을 해마다 다시 찾아가 묻는 종단 자료입니다. 같은 사람을 여덟 해 동안 따라갔으므로, 고2 시점의 가정 배경이 스물너덧 살의 인공지능 인식·역량과 어떻게 연결되는지 볼 수 있습니다. 다만 해마다 일부가 응답하지 않아 빠지므로(탈락), 남은 사람이 처음 표본과 같은지 확인해야 합니다.
정의와 수식
잔존율 = 7차 판단권 문항 응답자 / 1차 표본
       = 7,742 / 10,558 = 73.3%
잔존 로지스틱: logit P(잔존=1) = β₀ + 부모학력 + 아버지소득 + 고교유형 + 중3성적 + 성별 + 수도권
이 논문에서
- 1~8차 공개 원자료만 씁니다. 학술대회 전용 9차 자료는 이용 동의 조건에 따라 쓰지 않았고 스크립트에서 경로를 차단했습니다.
- 판단권 이양 전망은 7차 문항 응답자 7,742명, 리터러시와 앱 사용은 8차 세 문항 평균을 낼 수 있는 7,507명입니다. 두 차수 모두 응답한 사례는 7,247명입니다.
- 취업자로 한정하지 않아 진입 선택은 없으나 탈락은 남습니다. 부모 학력별 잔존율은 77.8~81.4%로 차이가 작지만, 특성화·마이스터고 69.4%, 중3 성적 최하위 4분위 64.5%(OR .537), 여성 70.8%(OR .71)로 낮습니다.
- 부모 학력 결측 1,546명은 잔존율 37.6%(OR .671, p=.038)입니다. 탈락이 학업 하위로 기울어 있으므로 원고는 격차가 하한일 수 있다고 적습니다.
- 표집 단위가 학교이므로 1차 학교 식별자(416개교)를 집락으로 보정합니다. 공개본에 가중치가 없어 모든 추정은 비가중입니다.
출처: 한국직업능력연구원 (2025). 『한국교육고용패널조사Ⅱ(KEEP II) 1~8차 원자료』. 탈락 수치는 S4_attrition.csv.
2. 종속변수 3개와 설문 원문
쉬운 설명
이 논문은 세 가지를 잽니다. 첫째는 "AI 때문에 사람이 중요한 결정을 하지 않게 될 것"이라는 전망에 얼마나 동의하는지, 둘째는 AI의 한계·윤리·법적 책임을 안다고 스스로 답한 정도, 셋째는 AI 앱을 써 본 적이 있는지입니다. 첫째 문항은 "부정적 영향"을 묻는 문항군 안에 있어서, 개인이 자기 판단을 맡기겠다는 의향이 아니라 인류 일반의 미래에 대한 3인칭 전망입니다.
정의와 수식
y_rq1 = L08S107011           (6점, 7차)   판단권 이양 전망
y_rq2 = mean(L08S108007, 008, 009)  (6점, 8차)   책임 있는 AI 리터러시, α = .914
y_use = 1[L08S108001 = 1]     (이분, 8차)   AI 앱 사용 경험
동의 = 1[y_rq1 ≥ 4]            리터러시 상위 = 1[y_rq2 ≥ 4.333] (34.6%)
이 논문에서
- 7차 347번 도입문: "10년 후 미래에 AI가 가져올 부정적 영향에 대해 어느 정도 동의하십니까?" 셋째 문항 「AI로 인해 인간은 중요한 선택과 결정을 하지 않을 것이다」가 주 종속변수입니다(평균 3.78, SD 1.27, 동의 64.2%, 5점 이상 31.2%).
- 8차 346번 「나는 AI 기술의 강점과 한계를 알고 있다」「나는 AI 시대에 가져야 할 윤리적 의무를 알고 있다」「나는 AI 기술을 사용하는 과정에서 지켜야 할 법적 책임을 알고 있다」의 평균이 리터러시입니다. 문항별 평균은 3.81, 3.68, 3.45로 법적 책임 인지가 가장 낮습니다.
- 8차 345번 「귀하는 AI 앱(프로그램)을 활용해본 경험이 있습니까?」가 앱 사용이며 39.2%(2,951명)입니다.
- 판단권 문항은 같은 문항군의 다른 문항과 분산을 공유합니다(유대감 약화 .550, 혜택 독점 .332, 개인정보 유출 .320, 일자리 감소 .294). 반면 「인간은 인공지능이나 로봇이 대체할 수 없는 능력을 갖고 있다」와의 상관은 .006이어서 합산하지 않았습니다.
- 민감도 분석에는 판단권 문항과 유대감 약화 문항의 평균(N=7,743, r=.55)을 씁니다.
- 세 문항이 재는 것은 인지이지 판단 수행이 아닙니다. 셋째 문항은 이용자가 지켜야 할 의무의 인지여서, 개인정보 보호법 제37조의2의 권리를 알고 행사하는 일과는 구인이 다릅니다.
출처: KEEP II 7차 설문 345~348번, 8차 설문 345~346번. 상관은 S21_rq1_item_corr.csv.
3. 예측변수 네 블록과 재코딩
쉬운 설명
설명하는 변수는 생애 순서대로 네 묶음입니다. 태어난 가정(M1), 고등학교 시절(M2), 대학과 일(M3), 그리고 종속변수와 같은 시점의 AI 이용·기대·위험 인식(M4)입니다. 나중 시점의 정보가 앞 시점의 결과를 설명하는 모순을 막기 위해, 7차 종속변수 분석에는 8차 변수를 넣지 않습니다.
정의와 수식
M1 가정 배경 (6)   : 성별, 부모 최고 학력, 아버지 월 소득, 수도권 거주, 도시 규모, 가정생활 만족도
M2 고교 시기 (16)  : 내신, 중3 성적, 수학·과학 자신감, 고교 유형 더미 2, 사교육비, 수학 과외·학원 …
M3 대학·노동 (5 / 8차 분석 7) : 전문대, 미진학, 공학·자연·의약, 수도권 대학, 7차 취업 (+8차 재직, 디지털 과업 수)
M4 AI 이용·기대·위험 (12 / 8차 분석 15)
이 논문에서
- 음수 결측코드는 결측으로 두고, 고교 시기 변수는 1차를 우선하되 결측은 2차로 채웠습니다.
- 고교 유형은 일반고 기준 두 더미(특성화·마이스터 / 특목·자율), 대학 유형은 4년제 기준 두 더미(전문대 / 미진학)입니다.
- 미진학은 대학 유형·계열·소재지가 모두 결측인 경우입니다. 대학 변수는 2차부터 마지막 비결측 응답을 최종 소속으로 삼되, 7차 분석은 7차까지만 보았습니다.
- 계열은 공학·자연·의약이면 1, 소재지는 서울·인천·경기를 수도권으로 묶었습니다. 사교육비는 10만 원 단위로 바꾸었고, 사교육 하위 문항의 구조적 결측은 "없음"으로 채웠습니다.
- 부모 최고 학력(1~8)과 아버지 월 소득(1~11)은 서열 코드를 등간 점수로 투입했습니다.
- M4의 013·014는 AI가 아니라 과학기술 일반을 가리키는 348번 문항이어서 "과학기술 일반 기대·위험"으로 따로 표기합니다.
출처: 논문 3장 2), 〈표 1〉. 코드는 「R 코드」 탭 2~4절.
4. A안 Post-LASSO — 자료가 변수를 고르게 하기
쉬운 설명
후보 변수가 380개가 넘으면 연구자가 보고 싶은 변수를 골라 넣을 여지가 커집니다. LASSO는 계수를 크게 쓰려면 벌금을 내라는 규칙을 회귀식에 붙여, 쓸모가 적은 변수의 계수를 정확히 0으로 만듭니다. 학교를 반으로 나눠 한쪽(훈련)에서 고르고, 다른 쪽(검증)에서 다시 확인합니다. 고른 뒤 검증 표본에서 보통 회귀로 다시 추정하므로 "Post-LASSO"라고 부릅니다.
정의와 수식
β̂ = argmin { Σᵢ (yᵢ − xᵢᵀβ)² + λ Σⱼ |βⱼ| }
CV(λ) = (1/10) Σₖ MSEₖ(λ),   λ.min = argmin CV(λ)
검증 R² = 1 − Σ(y − ŷ)² / Σ(y − ȳ)²   (검증 표본)
이 논문에서
- 후보는 결측률 30% 미만·분산 0 초과인 변수로 판단권 383개, 리터러시 385개입니다.
- 416개교를 208개씩 갈라 판단권은 훈련 3,877·검증 3,865명, 리터러시는 3,766·3,741명입니다.
- 훈련 표본에서 10겹 교차검증의 최소 오차 기준(λ.min)으로 벌점을 정했습니다. 검증 표본 R²는 판단권 .2514, 리터러시 .1382입니다.
- 원고가 밝힌 절차상 한계가 셋 있습니다. 결측 대체가 분할 전 일괄이어서 검증 설명량이 낙관적일 수 있고, 내부 10겹 교차검증은 학교 단위 겹을 쓰지 않았으며, 명목 코드(업종·용돈 소비 1순위)가 수치로 투입되었습니다(각주 7).
출처: Tibshirani (1996). 구현은 R glmnet의 cv.glmnet(alpha=1, nfolds=10).
5. 상관·분산팽창계수 필터, 검증 표본 집락 회귀, BH 보정
쉬운 설명
LASSO가 고른 변수 가운데 거의 같은 것을 재는 쌍이 있으면 계수가 불안정해집니다. 그래서 상관이 .7을 넘는 쌍은 하나를 빼고, 다른 변수들로 거의 설명되는 변수(분산팽창계수 5 초과)도 뺍니다. 남은 변수를 검증 표본에서 학교 집락을 고려해 다시 추정하고, 여러 변수를 한꺼번에 검정한 데 따른 거짓 발견을 줄이는 BH 보정값도 함께 봅니다.
정의와 수식
|r(xⱼ, xₖ)| > .7  → 우선순위(LASSO 계수 절댓값)가 낮은 쪽 제거
VIFⱼ = 1 / (1 − Rⱼ²) > 5 → 가장 큰 변수부터 하나씩 제거
BH: p₍₁₎ ≤ … ≤ p₍ₘ₎,  q₍ᵢ₎ = min_{k≥i} ( m · p₍ₖ₎ / k )
이 논문에서
- 판단권은 검증 p<.05 13개 가운데 BH 통과 10개입니다(〈표 3〉 주).
- 리터러시는 검증 p<.05 14개 가운데 BH 통과는 2개(일자리 출현 기대·번역 이용, q=.024)뿐이며, 계층·교육 위치 여섯은 q가 .124~.211로 모두 미통과입니다. 그래서 조건부 고유 기여는 탐색적입니다.
- 8차 재직 여부와 디지털 과업 수의 상관은 .765(검증 표본 .750)여서 필터가 과업 수를 사전 제거했습니다. 남은 재직 더미 단독은 검증 표본에서 유의하지 않았고(b=.042, p=.320), 과업 수를 남기는 대안에서는 유의합니다(b=.084, p<.001). 교차 확인 목록은 필터의 우선순위에 민감합니다.
- 고상관 쌍의 제거 순서는 원척도 LASSO 계수 크기를 따랐으므로 단위에 따라 달라질 수 있습니다(5장 5)).
출처: Benjamini & Hochberg (1995). 필터 부산물은 S24_filter_byproduct.csv.
6. B안 위계 회귀와 ΔR² — 이론이 변수를 고르게 하기
쉬운 설명
이번에는 연구자가 이론에 따라 변수를 정하고, 생애 순서대로 한 묶음씩 더해 갑니다. 새 묶음을 넣을 때 설명력이 얼마나 늘었는지(ΔR²)를 보면, 어느 시기의 특성이 결과와 더 많이 함께 움직이는지 알 수 있습니다. 같은 학교 학생끼리는 비슷하므로 표준오차를 학교 집락으로 보정합니다.
정의와 수식
Mₖ : y = β₀ + Σ_{블록 1..k} βⱼ xⱼ + ε
ΔR²ₖ = R²(Mₖ) − R²(Mₖ₋₁)
설계: svydesign(id = ~학교, weights = 1)  → 집락 보정·비가중
이 논문에서
- 판단권: M1 .0069, M2 .0097, M3 .0013, M4 .2406(최종 R² .2587). 세 블록을 다 넣어도 2%에 미치지 못합니다.
- M4의 설명량은 같은 세션·같은 척도의 이웃 문항이 만든 공분산이므로 전망의 원인으로 읽을 수 없습니다. 345번 이용 빈도가 .026, 346~348번 태도가 .214로 갈립니다.
- 리터러시: M1 .0321, M2 .0618, M3a(대학) .0107, M3b(8차 직무) .0289, M4 .0185(최종 R² .1520). M3 증가분의 4분의 3이 동시점 변수에서 옵니다.
- 블록별 설명량 증가는 형성 경로나 매개를 입증하지 않으며 후속 검증 과제입니다.
출처: 논문 〈표 3〉·〈표 4〉. R survey::svyglm.
7. 50회 반복 분할과 생존율
쉬운 설명
학교를 한 번만 나누면 운 좋게(또는 나쁘게) 나뉜 결과일 수 있습니다. 그래서 난수를 바꿔 학교를 50번 다시 나누고, 매번 LASSO가 어떤 변수를 고르는지 셉니다. 50번 중 30번(60%) 이상 뽑힌 변수만 안정적이라고 봅니다. 이 기준은 분석 전에 정했습니다.
정의와 수식
for r in 1..50:  seed = 2000 + r
    학교 50:50 분할 → 훈련 표본 중앙값으로 결측 대체 → cv.glmnet(λ.min)
생존율ⱼ = (선택 횟수ⱼ / 50) × 100,   안정 = 생존율 ≥ 60%
이 논문에서
- 생존율 60% 이상은 판단권 24개, 리터러시 44개입니다(
fit_summary.csv). - 회차마다 훈련 표본 중앙값으로 결측을 메워 주 분석의 분류·회귀나무 대체와 방식이 다르고, 벌점 모수도 한 점만 씁니다.
- 상관·분산팽창계수 제거와 검증 회귀는 되풀이하지 않습니다. 그래서 이 절차는 선택의 재현성을 볼 뿐 오선택률 통제 검정은 아닙니다.
출처: Meinshausen & Bühlmann (2010)의 안정성 선택에 착안.
8. 교차 확인 핵심 변수
쉬운 설명
선택 규칙이 다른 세 절차에서 함께 살아남은 변수만 "교차 확인"이라고 부릅니다. 자료 주도 절차의 검증 표본에서 유의하고, 이론 주도 위계 회귀의 최종 모형에서도 유의하며, 50회 반복에서 60% 이상 뽑혀야 합니다.
정의와 수식
교차 확인 = {검증 표본 p < .05} ∩ {위계 M4 p < .05} ∩ {생존율 ≥ 60%}
(BH 보정 통과는 요건이 아님)
이 논문에서
- 판단권은 10개로 모두 생존율 100%이고, 전부 같은 7차 AI 문항군입니다(개인정보 유출 .292, 혜택 독점 .252, 일자리 감소 .216, 외로움 해소 기대 .204 등). 계층 변수는 하나도 들지 못했습니다.
- 리터러시는 9개입니다. 기원에 해당하는 계층 변수는 부모 학력 하나이고, 대학 유형 둘·계열·소재지·중3 성적은 도달한 교육 위치입니다.
- 위계 최종 모형 유의는 이론 블록 안의 변수에만 적용되므로, 블록 밖의 안정 변수는 핵심이 될 수 없습니다. 블록 밖 안정 변수는 판단권 10개·리터러시 28개이고, 그중 검증 p<.05인 일곱의 BH 통과는 0입니다.
- 이 규칙은 이론 블록에 조건부이며, 원고는 그 한계를 4장 6)에 적었습니다.
출처: 논문 3장 3), 〈표 3〉·〈표 4〉 주, S15_offblock_stable.csv.
9. 계층 격차 검정
쉬운 설명
부모 학력을 세 범주(고졸 이하·전문대·4년제 이상)로 나누어 각 결과의 분포를 보고, 범주가 올라갈수록 결과가 한 방향으로 움직이는지(추세) 검정합니다. 또 부모 학력과 아버지 소득을 표준화해, 표준편차 1만큼 높아질 때 결과가 얼마나 달라지는지를 OR이나 계수로 봅니다. 검정을 열 번 하므로 우연히 유의해 보일 위험을 줄이려고 Bonferroni 기준을 씁니다.
정의와 수식
비율 추세: prop.trend.test (집락 미보정)
평균 추세: y ~ 서열점수, 집락 보정 회귀
표준화 모형: logit P(y=1) 또는 y = β₀ + β·z(SES) + 성별 + 수도권 거주
OR = exp(β)   (z(SES) +1SD당)
Bonferroni: α = .05 / 10 = .005   (결과 5 × 계층 축 2)
이 논문에서
- 부모 학력은 다섯 결과 모두 Bonferroni를 통과했습니다. 아버지 소득은 리터러시 평균과 앱 사용에서만 통과해, 소득은 전망 동의에 걸리지 않고 역량에만 걸립니다.
- 리터러시 상위 집단은 절단점 4.333 이상인 34.6%입니다. 아버지 소득은 결측 집단(34.2%)을 별도 행으로 두고 추세 검정에서 뺐습니다.
- 서열형 부모 학력을 연속형으로 표준화했으므로 이 기울기는 서열 간격을 등간으로 가정한 근사입니다.
- 잔존 확률의 역가중으로 다시 추정해도 리터러시 평균 β .167→.170(N=6,940), 판단권 동의 OR .907→.907(N=7,157)로 거의 그대로였습니다.
출처: 〈표 2〉·〈표 5〉, G1_gradient_table.csv, G2_ses_or.csv, S22_ipw_gradient.csv.
10. 두 기울기 차이와 학교 집락 부트스트랩 400회
쉬운 설명
"전망은 계층을 덜 따르고 리터러시는 더 따른다"를 말하려면 두 기울기의 차이가 우연이 아닌지 봐야 합니다. 두 결과를 같은 척도(표준점수)로 바꾸고, 학교를 복원추출로 400번 다시 뽑아 차이의 분포를 만듭니다. 그 분포의 가운데 95%가 0을 포함하지 않으면 차이가 있다고 봅니다.
정의와 수식
β₁ : z(전망) ~ z(부모학력),   β₂ : z(리터러시) ~ z(부모학력)
D = |β₂| − |β₁|
부트스트랩: 416개교를 복원추출 × 400회 → D의 2.5·97.5 백분위
이 논문에서
- 7·8차 공통 표본 N=6,728(416개교)에서 β₁=−.049, β₂=.153, 절댓값 차이 .104, 95% 신뢰구간 [.065, .140]입니다.
- 이 값은 절댓값의 차이입니다. 부호를 그대로 두고 빼면 두 기울기의 거리는 반올림 값 기준 .153 − (−.049) = .202가 되며, 원고가 보고하는 것은 앞의 .104입니다.
- 전망은 단일 문항이고 리터러시는 세 문항 평균(α=.914)이어서 측정 오차 감쇠가 전망 쪽에 더 클 수 있습니다. 단일 문항 신뢰도를 .5~.6으로 가정해 보정하면 차이는 약 .08~.09로 줄지만 결론은 같습니다.
출처: S5_slope_diff.csv, 논문 4장 4).
11. 결측 처리: 단일 대체(m=1)와 다중대체(m=20)
쉬운 설명
빈칸을 채우는 방법에 따라 결과가 흔들릴 수 있습니다. 이 논문은 변수 선택 파이프라인에는 한 번 채운 자료(m=1)를 쓰고, 계층 계수를 해석할 때는 스무 번 채운 결과를 규칙에 따라 합친 값(m=20)을 기준으로 삼습니다. 스무 벌을 합치면 "빈칸을 어떻게 채웠느냐"에서 오는 불확실성이 표준오차에 반영됩니다.
정의와 수식
m=1  : mice(method = "cart", m = 1, 종속변수 제외) + 남은 칸 중앙값
m=20 : mice(method = "cart", m = 20, 종속변수 포함)
Rubin 결합: Q̄ = (1/m) Σ Qₗ,  T = Ū + (1 + 1/m) B
이 논문에서
- 〈표 3〉·〈표 4〉의 계수와 R²는 단일 대체본 추정치입니다. 계층 변수의 추론 기준은 종속변수를 포함한 m=20 결합 추정치로 표 주에 병기했습니다.
- 판단권의 부모 학력 계수(m=20)는 M1 −.051*** → M2 −.023 → M3 −.023 → M4 −.016입니다. 종속변수를 뺀 같은 절차의 −.016(p=.215)과 같아, 종속변수를 뺀 대체의 편향은 확인되지 않습니다.
- 리터러시는 .136 → .067 → .055 → .054로 전 단계 p<.001입니다.
- 완전사례에서는 판단권 부모 학력 계수가 모든 단계에서 p<.05로 유지되고(최종 −.032), 같은 사양에서도 대체본에 따라 p가 .22와 .054 사이에서 움직입니다. 판단권 총연관의 경계는 대체본에 민감합니다.
출처: van Buuren & Groothuis-Oudshoorn (2011). S2_impute_compare_rq1.csv, S3_paredu_trajectory.csv, S18_mi_with_dv.csv.
12. 강건성과 한계
쉬운 설명
결론이 한 가지 분석 선택에만 기대고 있지 않은지 다른 방식으로 다시 확인합니다. 그리고 이 자료와 설계로는 답할 수 없는 것을 한계로 적습니다.
정의와 수식
강건성 1: M4 전 단계(M1~M3)에서 계층 변수 유의성
강건성 2: 민감도 종속변수(판단권 + 유대감 약화 평균)
강건성 3: 이분화 로지스틱(AUC)
강건성 4: 수도권 거주와 앱 사용(억제 가능성)
강건성 5: 완전사례 / m=1 / m=20 비교
이 논문에서
- M1~M3(결정계수 .018)에서 유의한 것은 성별과 고교 시기 네 항목뿐이고 부모 학력 −.017(p=.219)을 비롯한 계층 변수는 p>.05였습니다.
- 이분화 로지스틱의 최종 단계에서는 전문대(OR 1.186, p=.024)와 아버지 소득(OR 1.032, p=.031)이 유의해 계층 무연관이 모든 사양에서 같지는 않습니다.
- 수도권 거주자의 앱 사용률이 낮은 결과(34.7% 대 43.5%)는 해명되지 않은 채 한계로 남겼습니다.
- 한계는 측정(단일 문항, 부정 프레임, 자기보고 인지), 설계와 추정(공통방법분산, 단일 대체, 학교 단위 겹 없는 교차검증, 필터 순서), 일반화(단일 코호트, 선택적 탈락, 결정 영역 미구분)의 세 묶음입니다.
출처: 논문 4장 6), 5장 5).
다섯 차례의 심사 기록과 외부 검토에서 나온 질문 40개와, 현행 원고가 어떻게 답하는지를 정리했습니다. 분류를 고르거나 검색어를 넣어 좁힐 수 있습니다.
1. 인간 개입(HITL)과 명목적 개입 — 황지은 (2020)
핵심 명제
자동화된 결정에 사람이 개입해야 한다는 요구는 GDPR 제22조로 정식화되었으나, 기준이 없고 단계가 불분명하며 정보와 역량이 모자라 실질적 개입도 감독도 어렵습니다. 실질과 명목을 가르는 첫 기준은 검토자의 이해입니다. "인공지능 판단과정에 대한 이해가 전혀 없다면 인간이 개입하더라도 이는 인공지능의 결정을 무비판적으로 수용하는 것에 불과한 명목적인 인간 개입이 될 수 있"습니다(황지은, 2020, 48).
이 논문에서의 역할
책임 있는 리터러시를 판단권 보장의 전제로 읽는 근거입니다. 정부 층 첫째 제언은 황지은의 세 기준(검토자의 이해, 실제 검토 행위, 근거 설명 가능성)을 고시의 출발점으로 제시합니다. 4유형 가운데 전망에 동의하지 않으면서 리터러시도 낮은 13.8%는 이 논리대로라면 무비판적 수용 위험이 더 클 수 있다고 적었습니다.
출처: 황지은 (2020). 인공지능 관점에서 GDPR 제22조의 인간 개입에 대한 분석. 「경제규제와 법」, 13(1), 37-58.
2. 개입의 실질화와 유럽연합 인공지능법 제14조 — 정애령 (2026)
핵심 명제
유럽사법재판소 Schufa 판결(2023.12.7.)은 신용평가 점수가 금융기관 결정을 좌우하면 점수 산정 자체가 자동화된 결정에 든다고 보았고, 개입의 정도는 참여 여부가 아니라 감독자의 자격과 판단력으로 따져야 합니다. 유럽연합 인공지능법 제14조 제4항은 감독자에게 시스템의 능력과 한계 이해, 자동화 편향의 인지, 산출물을 쓰지 않을 권한을 요구하고, 제4조는 공급자·배포자에게 리터러시 확보 조치를 요구합니다.
이 논문에서의 역할
인공지능 기본법 제34조 제1항 제4호의 "사람의 관리·감독"이 역량 요건도 개입 권한도 두지 않는다는 대비의 기준입니다. 다만 제34조와 제14조의 감독자는 배포자 측 자연인이고 이 논문의 청년은 결정을 받는 상대방이므로, 원고는 두 지위를 구분하고 당사자 역량의 근거를 개인정보 보호법 제37조의2에서 찾습니다.
출처: 정애령 (2026). 인공지능의 자동화된 의사결정에 대한 인간의 개입. 「유럽헌법연구」, 50, 161-187. / Regulation (EU) 2024/1689 (Artificial Intelligence Act), Articles 4, 14.
3. 자동화된 결정에 대한 정보주체의 권리 — 정란 (2025), 박노형·김효권 (2022)
핵심 명제
개인정보 보호법 제37조의2는 완전히 자동화된 결정이 권리·의무에 중대한 영향을 미치면 정보주체가 거부하고(제1항) 설명을 요구할 수 있게 하며(제2항), 처리자는 정당한 사유가 없으면 인적 개입에 의한 재처리 등을 해야 합니다(제3항). 정란은 이 규율이 3단계 구조이면서도 재검토 절차가 구체적이지 않아 형식화될 소지를 지적했고, 박노형·김효권은 원칙적 허용 구조와 입증책임 전가를 비판했습니다(2021년 개정안 단계 해설).
이 논문에서의 역할
청구권은 행사되어야 작동하고, 행사에는 결정이 자동화되었음을 알아차리고 근거를 따져 물을 역량이 듭니다. 이 논문은 그 역량의 전제가 되는 자기보고 인지가 계층에 따라 갈리는지를 묻습니다. 기업 층 둘째 제언(고지 형식)도 이 조항의 제4항에 걸립니다.
출처: 정란 (2025). 자동화된 의사결정 규제에 관한 비교법적 고찰 및 한국 법제에의 시사점. 「미디어와 인격권」, 11(3), 43-102. / 박노형·김효권 (2022). 자동화된 결정에 관한 개인정보보호법 정부 개정안 신설 규정의 문제점: EU GDPR과의 비교 분석. 「사법」, 62, 361-390.
4. 교육 분야 고영향 인공지능과 책임 전가 — 김준서 (2026), 우창빈 (2025)
핵심 명제
인공지능 기본법의 교육 분야 적용 영역은 "학생 평가"로 좁아 학습 경로 추천과 학습 위험 예측이 규제 밖에 남고, 교사 개입 여부를 기준으로 삼는 가이드라인 탓에 교육 분야 고영향 인공지능 사례는 발생하기 어렵습니다. 그 결과 사업자 책무인 사람의 개입이 교사에게 전가됩니다. 우창빈은 어떤 결정을 인공지능에 맡길지 먼저 정하는 메타 의사결정을 출발점으로 봅니다.
이 논문에서의 역할
정부 층 둘째 제언(카목에 진로·학습 경로 추천 추가)과 기업 층 넷째 제언(시행령 제27조 제4항 개발사업자 자료 협력의 의무화)의 근거입니다. 김준서(2026, 98)가 지적한 학생의 설명 요구·이의제기 절차 부재에 대해, 원고는 절차가 있어도 행사할 역량이 없으면 결과는 같다고 덧붙입니다.
출처: 김준서 (2026). 인공지능기본법상 교육 분야 고영향 인공지능에 관한 법적 쟁점. 「교육법학연구」, 38(2), 83-104. / 우창빈 (2025). 인공지능(AI) 시대 정부의 도전과제의 대응 및 공무원의 필요역량: 인간중심 다층-메타 AI 거버넌스. 「Crisisonomy」, 21(12), 61-86.
5. 알고리즘 혐오 — Dietvorst et al. (2015)
핵심 명제
모형이 사람보다 더 정확해도, 모형이 틀리는 것을 본 참가자는 모형을 더 기피합니다. 다섯 실험에서 확인된 이 현상을 알고리즘 혐오라고 부릅니다.
이 논문에서의 역할
판단권 이양 전망이 이후 사용과 어떻게 연관될지에 대한 한쪽 예상입니다. 다만 이 실험들은 자기 과제를 맡길지 정하는 행동을 쟀고, 이 논문의 종속변수는 3인칭 전망이어서 층위가 다릅니다. 연구 가설 (3)은 기피 연구와 양가성 연구가 다른 방향을 시사하므로 탐색적으로 둡니다.
출처: Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Algorithm aversion: People erroneously avoid algorithms after seeing them err. Journal of Experimental Psychology: General, 144(1), 114-126.
6. 알고리즘 선호 — Logg et al. (2019)
핵심 명제
출처 라벨만 바꾼 실험에서 사람들은 알고리즘의 조언에 더 높은 가중치를 두었습니다(실험 1A: .45 대 .30, d=.42). 그러나 비교 대상이 자기 자신이면 알고리즘 선택이 88%에서 66%로 떨어졌고, 국가 안보 예측 전문가는 알고리즘 조언을 크게 할인했습니다.
이 논문에서의 역할
알고리즘 위임 실험의 결과가 조건에 따라 갈린다는 점을 보여 주어, 판단권 이양 전망의 방향을 미리 정하지 않는 근거가 됩니다.
출처: Logg, J. M., Minson, J. A., & Moore, D. A. (2019). Algorithm appreciation: People prefer algorithmic to human judgment. Organizational Behavior and Human Decision Processes, 151, 90-103.
7. 자동화된 결정에 대한 인식과 계층 — Araujo et al. (2020)과 국내 연구
핵심 명제
네덜란드 표본 958명에서 교육 수준은 유용성 인식과만, 도메인 지식은 유용성·공정성과 연관되고 둘 다 위험 인식과는 무관했습니다. 국내에서는 자율주행 사고의 통제가능성을 사람 운전자보다 낮게 보고(주연경, 2023), 도덕적 영역의 수용도가 사회인습적·개인적 영역보다 낮았습니다(박보람·노성호, 2026).
이 논문에서의 역할
연구 가설 (1)에서 판단권 전망의 계층 격차를 열린 물음으로 두는 근거입니다. 생명과 해악이 걸린 판단일수록 위임 거부가 강하다는 관찰은 정부 층에서 보장 영역을 그런 판단부터 법정화하자는 제언으로 이어집니다. 박보람·노성호는 43명의 탐색적 연구이고 내적 일관성이 낮아(α=.24) 순서만 인용합니다.
출처: Araujo, T., Helberger, N., Kruikemeier, S., & de Vreese, C. H. (2020). In AI we trust? Perceptions about automated decision-making by artificial intelligence. AI & Society, 35, 611-623. / 주연경 (2023). 알고리즘 혐오와 자율주행차 사고에 대한 대중의 인식: 통제가능성, 불안도, 사고에 대한 책임을 중심으로. 「차세대융합기술학회논문지」, 7(8), 1346-1357. / 박보람·노성호 (2026). 대학생의 인공지능 기반 의사결정 수용도 분석: 사회인지영역이론에 따른 영역별 판단 비교. 「교육연구」, 95, 287-308.
8. 인공지능 리터러시 — Long & Magerko (2020)
핵심 명제
인공지능 리터러시는 "인공지능 기술을 비판적으로 평가하고, 인공지능과 효과적으로 소통·협업하며, 온라인과 가정과 직장에서 인공지능을 도구로 쓸 수 있게 하는 역량의 집합"입니다. 역량 5는 "언제 인공지능을 쓰는 것이 적절하고 언제 사람의 역량을 활용할지 판단하라", 역량 16은 윤리 쟁점을 식별하고 서술하는 능력입니다.
이 논문에서의 역할
8차 세 문항 가운데 「강점과 한계」는 역량 5에, 「윤리적 의무」「법적 책임」은 역량 16에 대응합니다. 다만 세 문항이 재는 것은 인지이지 판단 수행이 아니어서 역량 5의 판단 성분까지 담지는 못한다고 원고는 한정합니다.
출처: Long, D., & Magerko, B. (2020). What is AI literacy? Competencies and design considerations. Proceedings of the 2020 CHI Conference on Human Factors in Computing Systems, Paper 598, 1-16.
9. 리터러시는 한 덩어리가 아니다 — 노환호 외 (2024)
핵심 명제
한국형 생성 인공지능 리터러시 척도의 4요인 가운데 지각된 위험과의 상관은 윤리적 사용 .191, 창의적 활용 .179, 비판적 평가 .164만 유의하고 활용능력은 .028입니다. 저자들은 "기존의 사용 역량을 높이는 데 초점을 맞추는 것이 아니라 (…) 윤리적인 부분을 고려하는 것이 필요하다"라고 적었습니다. 권동진·권창미(2025)도 인공지능 리터러시가 디지털 리터러시와 구별됨을 보고했으나 통제집단 없는 66명 설계입니다.
이 논문에서의 역할
8차 AI 준비도 블록에서 앱 경험자에게만 묻는 활용 역량 다섯 문항을 빼고 전원이 답한 책임 인지 세 문항만 쓰는 이유의 하나입니다. 같은 블록을 정지영·김난옥(2025)은 여덟 문항 단일 척도로, 임다미·이영(2025)은 평균 지표로 다뤘습니다.
출처: 노환호·김현정·김민진 (2024). 한국형 생성 인공지능 리터러시 척도 개발 및 타당화. 「지식경영연구」, 25(3), 145-171. / 권동진·권창미 (2025). 대학 수업에서 인공지능 리터러시와 디지털 리터러시의 차별적 효과 분석: 역량 인식 변화를 중심으로. 「사고개발」, 21(3), 195-210.
10. 2차 디지털 격차와 사용 격차 — Hargittai (2002), van Deursen & van Dijk (2014)
핵심 명제
접근이 넓어진 뒤에도 온라인 기술의 차이는 남습니다(2차 격차). 격차의 무게중심은 접근과 기술을 지나 무엇에 쓰는가로 옮겨 갔습니다.
이 논문에서의 역할
이 논문이 재는 리터러시는 접근의 문제도 도구를 조작하는 기술의 문제도 아닙니다. 강점과 한계를 알고 윤리적·법적 책임을 인지하는 일은 같은 도구를 쓰면서도 갈리는 지식과 전유의 층위에 놓입니다. 그래서 미진학 29.8%, 전문대 31.1%가 이미 앱을 써 본 집단이 "이용에 어려움"이라는 접근 중심 정의에 걸리지 않는 문제가 정부 층 제언의 출발점이 됩니다.
출처: Hargittai, E. (2002). Second-level digital divide: Differences in people's online skills. First Monday, 7(4). / van Deursen, A. J. A. M., & van Dijk, J. A. G. M. (2014). The digital divide shifts to differences in usage. New Media & Society, 16(3), 507-526.
11. 자원-전유 모형 — van Dijk (2005)
핵심 명제
디지털 격차는 자원(시간·돈·교육·사회적 관계)이 기술의 전유로 이어지는 누적 과정입니다. 자원의 불평등이 접근·기술·사용의 불평등으로 차례로 옮겨 갑니다.
이 논문에서의 역할
연구 가설 (2) "리터러시는 가정 배경에서 직무까지 누적된 차이를 보일 것"의 이론적 배경입니다. 실제로 리터러시는 가정·고교·대학·직무 블록이 차례로 설명량을 더했지만, 원고는 블록별 설명량 증가가 형성 경로나 매개를 입증하지 않는다고 적습니다.
출처: van Dijk, J. A. G. M. (2005). The deepening divide: Inequality in the information society. Sage.
12. 청년은 예외인가 — 세대 내 격차 연구
핵심 명제
청년세대는 "정보 활용수준이 가장 높은 집단으로 인식되어 이에 대한 논의가 부족"했으나 세대 안에서도 고활용 27.2%·저활용 26.3%로 갈립니다(김설인·구혜경, 2021). 생성형 AI 이용자 가운데 검증지향 고활용형은 5.5%, 저소득에서는 1.1%였고(이슬기, 2025), 이용률은 종사상 지위에 따라 39.7%와 6.6%로 갈렸습니다(오주현, 2026).
이 논문에서의 역할
청년 안의 격차를 본 연구는 인공지능을 다루지 않았고, 인공지능 격차를 본 연구는 성인 일반을 대상으로 삼았다는 공백을 채우는 근거입니다. 디지털 정보격차 실태조사에서 20대의 디지털정보화 수준이 124.3%로 조사 설계가 청년을 격차 없는 집단으로 다룬다는 서론의 지적과 함께, 정부 층 셋째 제언(조사 개편)으로 이어집니다.
출처: 김설인·구혜경 (2021). 청년은 정보 활용격차에서 자유로운가?: 한국 2030 청년세대의 모바일 정보 활용에 관한 연구. 「한국콘텐츠학회논문지」, 21(1), 39-54. / 이슬기 (2025). AI의 편리함은 누구에게 역설이 되는가?: 생성형 AI 이용 레퍼토리와 정보격차 요인에 따른 신뢰, 편의, 의존 인식 차이. 「사이버커뮤니케이션학보」, 42(4), 145-194. / 오주현 (2026). AI 포용 관점에서 본 생성형 인공지능(AI) 이용 격차: 인지, 이용, 활용. 「KISDI STAT Report」, 26-04, 1-8.
부기. 계층(기원)과 교육·직무 위치(도달)의 구분, 그리고 KEEP II 선행 사용
- 이 논문에서 계층은 출신 배경인 부모 학력과 아버지 소득을, 교육·직무 위치는 본인이 지나온 대학 유형·계열·소재지와 재직 여부·직무의 디지털 강도를 가리킵니다. 전자는 기원, 후자는 도달이며 둘을 가르지 않으면 계층 격차는 학력·직무 격차와 구별되지 않습니다.
- KEEP II로 청년의 인공지능 인식을 본 연구는 이미 있습니다. 김소희·이기혜(2022)는 4차(2020) 부가조사에서 판단권 문항을 일자리 감소·개인정보 유출·유대감 약화와 묶어 "부정적 인식" 4문항 평균(α=.72)으로 썼고, 박성준·나종민(2025)은 7차 자료의 같은 네 문항을 "인공지능에 대한 부정적 태도" 척도(α=.703)로 합산했습니다.
- 이 논문은 이 문항을 합산에서 떼어내 일자리 감소와 개인정보 유출을 통제한 뒤 고유 성분이 남는지 검증한다는 점에서 구분됩니다. 합산 평균의 부모 학력 기울기는 −.003(p=.79)이고, 판단권 문항을 떼어낸 잔차는 −.063(p<.001)입니다.
- 출처: 김소희·이기혜 (2022). AI로 인한 미래 사회변화에 대한 대학생의 인식에 영향을 미치는 요인 탐색: 대학유형별 비교를 중심으로. 「한국교육학연구」, 28(4), 23-46. / 박성준·나종민 (2025). 계획된 행동이론으로 바라본 청년층의 인공지능 수용에 대한 자기효능감과 우울감의 조절된 매개효과. 『2025 KRIVET 패널 학술대회 자료집』 77-100.
원자료(KEEP II 1~8차)와 개인 수준 데이터는 이 사이트에 공개하지 않습니다. 아래는 분석 스크립트에서 원문 그대로 발췌한 코드와 집계 결과의 출처입니다. 스크립트 위치: C:\Claude\108 ai 디지털 소사이어티 논문 공모\R분석\ · 산출 위치: 같은 폴더의 결과/rq1, 결과/rq2, 결과/gradient, 결과/supp. 난수 시드는 2026으로 고정했고, 50회 반복 분할은 회차별 2000+r입니다. 분석 환경은 R 4.5.2(glmnet·survey·car·mice)입니다.
1. 원자료 규정 확인과 설정 (9차 차단)
원자료 파일명에 「1~8차」가 없으면 멈추도록 해서, 학술대회 전용 9차 자료가 섞이지 않게 막습니다. 보조 스크립트(42~45)도 경로에 「9차」가 들어가면 멈추는 같은 차단을 둡니다.
# ── (0) 설정 ────────────────────────────────────────────────────────────────
D103    <- list.files("C:/Claude", pattern = "^103", full.names = TRUE)[1]
PATH_SAV <- list.files(D103, pattern = "raw data.*\\.SAV$", full.names = TRUE,
                       ignore.case = TRUE)[1]
PATH_CB  <- list.files(D103, pattern = "Layout.*\\.xlsx$", full.names = TRUE)[1]
OUTDIR   <- "C:/Claude/108 ai 디지털 소사이어티 논문 공모/R분석"
MISS_THR <- 0.30   # 후보 예측변수 결측률 상한
SEED     <- 2026

# 규정 확인: 1~8차 통합 원자료만 사용
stopifnot(grepl("1~8차", basename(PATH_SAV)), grepl("1~8차", basename(PATH_CB)))

dir.create(OUTDIR, showWarnings = FALSE, recursive = TRUE)
suppressPackageStartupMessages({library(haven); library(dplyr); library(readxl)})
set.seed(SEED)
2. 종속변수와 파생변수 구성
사교육 경험이 없는 사람의 과목별 하위 문항 결측을 「없음(2)」으로 채우고, 내신 평균·수도권 거주·부모 최고 학력·7차 취업·8차 재직을 만든 뒤 종속변수 넷(판단권 전망, 민감도 지수, 리터러시 평균, 앱 사용)을 정의합니다.
# 사교육 과목별 하위문항: 사교육 경험 자체가 없는 사람(001==2)의 NA → 2(없음)
sk_sub <- intersect(paste0(sprintf("L08H104%03d", 2:30), "_hs"), names(wide))
no_sk  <- !is.na(wide$L08H104001_hs) & wide$L08H104001_hs == 2
n_fill <- sum(vapply(sk_sub, function(v) sum(no_sk & is.na(wide[[v]])), integer(1)))
for (v in sk_sub) wide[[v]][no_sk & is.na(wide[[v]])] <- 2
cat(sprintf("\n▶ 사교육 하위문항 %d개: 비경험자(001==2, %d명) 결측 %d칸 → 2(없음) 채움\n",
            length(sk_sub), sum(no_sk), n_fill))

# ── (5) 파생변수 (105 정본 122~145줄 이식) ──────────────────────────────────
nv <- paste0("L08H102", sprintf("%03d", 65:69), "_hs")   # 고3 1학기 내신 5과목
wide <- wide %>% mutate(
  naesin_avg  = nan2na(rowMeans(across(all_of(nv)), na.rm = TRUE)),
  grade_drop  = naesin_avg - L08H102153_hs,
  dosi_gyumo  = L08F101025_hs,
  is_Seoul    = ifelse(is.na(L08F101024_hs), NA, ifelse(L08F101024_hs == 1, 1, 0)),
  is_Capital  = ifelse(is.na(L08F101024_hs), NA, ifelse(L08F101024_hs %in% c(1, 4, 8), 1, 0)),
  par_edu_max = nan2na(pmax(L08F104021_hs, L08F104051_hs, na.rm = TRUE)),
  fa_income   = L08F104027_hs,
  emp_w7      = as.integer(!is.na(L08J302012_w7)),
  emp_w8      = as.integer(!is.na(L08S109001_w8)))

# ── (6) 종속변수 ────────────────────────────────────────────────────────────
wide <- wide %>% mutate(
  y_rq1  = L08S107011_w7,
  y_rq1b = nan2na(rowMeans(across(c(L08S107011_w7, L08S107012_w7)), na.rm = TRUE)),
  y_rq2  = nan2na(rowMeans(across(c(L08S108007_w8, L08S108008_w8, L08S108009_w8)), na.rm = TRUE)),
  y_use  = ifelse(is.na(L08S108001_w8), NA_integer_, as.integer(L08S108001_w8 == 1)))
3. 재코딩: 고교 유형·대학 유형·계열·소재지·디지털 과업
미진학은 대학 유형·계열·소재지가 모두 결측일 때로 정의합니다. 판단권 분석은 2~7차, 리터러시 분석은 2~8차의 마지막 응답을 최종 소속으로 씁니다. 디지털 과업 수는 8차 재직자가 「수행한다(2)」라고 답한 과업의 개수입니다.
# (3-2) 대학 유형 3범주: 4년제(4,5,6 · 기타7 포함=기준) / 전문대(1,2,3) / 미진학
# 미진학 = 대학 유형·계열·소재지가 모두 결측일 때만
mk_univ <- function(type, major, region) {
  none <- is.na(type) & is.na(major) & is.na(region)
  jun  <- ifelse(none, 0, ifelse(is.na(type), NA, as.integer(type %in% c(1, 2, 3))))
  list(junior = jun, none = as.integer(none))
}
U <- if (TARGET_DV == "rq1")
  mk_univ(d$univ_type_w7last, d$univ_major_w7last, d$univ_region_w7last) else
  mk_univ(d$univ_type_last,   d$univ_major_last,   d$univ_region_last)
maj <- if (TARGET_DV == "rq1") d$univ_major_w7last else d$univ_major_last
reg <- if (TARGET_DV == "rq1") d$univ_region_w7last else d$univ_region_last
cat(sprintf("\n  [대학 변수] RQ1=%s | 미진학 %d명 / 전문대 %d명 / 4년제·기타 %d명 / NA %d명\n",
            if (TARGET_DV == "rq1") "univ_*_w7last" else "univ_*_last",
            sum(U$none), sum(U$junior == 1, na.rm = TRUE),
            sum(U$junior == 0 & U$none == 0, na.rm = TRUE), sum(is.na(U$junior))))

dgt <- sprintf("L08S109%03d_w8", 1:6)
d <- d %>% mutate(
  hs_voc   = ifelse(is.na(L08H101002_hs), NA, as.integer(L08H101002_hs %in% c(3, 8))),
  hs_elite = ifelse(is.na(L08H101002_hs), NA, as.integer(L08H101002_hs %in% c(2, 4, 5, 6, 7))),
  univ_junior  = U$junior,
  univ_none    = U$none,
  # 계열 대분류 = 코드 첫자리 (1인문 2사회 3교육 4공학 5자연 6의약 7예체능) → 4·5·6 = STEM
  stem         = ifelse(U$none == 1, 0L,
                   ifelse(is.na(maj), NA, as.integer(as.integer(substr(as.character(maj), 1, 1)) %in% c(4, 5, 6)))),
  univ_capital = ifelse(U$none == 1, 0L,
                   ifelse(is.na(reg), NA, as.integer(reg %in% c(1, 4, 8)))),
  # ※ L08H104150_hs 는 '원' 단위(중위 0 / 75% 450,000 / 최대 30,000,000) → 10만원 단위로 환산
  edu_cost10   = L08H104150_hs / 100000,
  ai_use_idx   = nan2na(rowMeans(across(all_of(sprintf("L08S107%03d_w7", 1:4))), na.rm = TRUE)),
  ai_hope_idx  = nan2na(rowMeans(across(all_of(sprintf("L08S107%03d_w7", 5:8))), na.rm = TRUE)),
  digital_tasks = ifelse(emp_w8 == 0, 0, rowSums(across(all_of(dgt)) == 2, na.rm = TRUE)))
4. 분석 표본과 이론 블록 M1~M4
이론 주도 절차(B안)에 넣을 네 블록입니다. 리터러시 분석에서는 M3에 8차 재직·과업 수, M4에 7차 판단권 전망·유대감 약화·대체불가 능력을 더합니다.
# ── (4) 분석 표본 ────────────────────────────────────────────────────────────
d$yy <- if (TARGET_DV == "rq1") d$y_rq1 else d$y_rq2
full <- d[!is.na(d$yy), ]
full$W1 <- 1.0
schools <- unique(full$Y16AID)
cat(sprintf("\n▶ 분석표본(%s): N=%d | 학교 %d개 | DV 평균 %.3f (SD %.3f, 범위 %.2f~%.2f)\n",
            TARGET_DV, nrow(full), length(schools), mean(full$yy), sd(full$yy),
            min(full$yy), max(full$yy)))

# ── (5) B안 이론 블록 ────────────────────────────────────────────────────────
vars_m1 <- c("GENDER", "par_edu_max", "fa_income", "is_Capital", "dosi_gyumo", "L08F103001_hs")
vars_m2 <- c("naesin_avg", "L08H102153_hs", "L08H102042_hs", "L08H102048_hs",
             "hs_voc", "hs_elite", "edu_cost10", "L08H104019_hs", "L08H104010_hs",
             "L08H102030_hs", "L08H102035_hs", "L08H102087_hs", "L08H102125_hs",
             "L08H102126_hs", "L08L102005_hs", "L08G101004_hs")
vars_m3 <- c("univ_junior", "univ_none", "stem", "univ_capital", "emp_w7")
if (TARGET_DV == "rq2") vars_m3 <- c(vars_m3, "emp_w8", "digital_tasks")
vars_m4 <- c(sprintf("L08S107%03d_w7", c(1:10, 13, 14)))
if (TARGET_DV == "rq2") vars_m4 <- c(vars_m4, sprintf("L08S107%03d_w7", c(11, 12, 15)))
all_theory <- unique(c(vars_m1, vars_m2, vars_m3, vars_m4))
miss_theory <- setdiff(all_theory, names(full))
cat(sprintf("\n▶ B안 이론변수: M1 %d / M2 %d / M3 %d / M4 %d (합 %d)\n",
            length(vars_m1), length(vars_m2), length(vars_m3), length(vars_m4), length(all_theory)))
if (length(miss_theory)) cat("  *** 데이터에 없어 제외:", paste(miss_theory, collapse = ", "), "\n") else
  cat("  데이터에 없는 이론변수: 없음\n")
5. 자료 주도 후보와 누수 검사, 학교 단위 50:50 분할
판단권 분석에서는 8차 변수(_w8)를 후보에서 모두 빼고 남은 개수가 0인지 출력합니다. 결측률 30% 미만·분산 0 초과 후보만 남긴 뒤 416개교를 절반씩 나눕니다.
# ── (6) A안 후보 ─────────────────────────────────────────────────────────────
DERIV_NEW <- c("hs_voc", "hs_elite", "univ_junior", "univ_none", "stem", "univ_capital", "edu_cost10")
if (TARGET_DV == "rq2") DERIV_NEW <- c(DERIV_NEW, "emp_w8", "digital_tasks")
# 재코딩으로 대체된 원변수는 후보에서 뺀다(명목코드 오해석 방지)
RECODED <- c("L08H101002_hs", "L08H104150_hs",
             "univ_type_last", "univ_major_last", "univ_region_last", "univ_adm_last",
             "univ_type_w7last", "univ_major_w7last", "univ_region_w7last")

cand0 <- DICT$var[DICT$block_M %in% c("M1", "M2", "M3", "M4", "CTRL_RISK")]
cand0 <- setdiff(union(cand0, DERIV_NEW), RECODED)
if (TARGET_DV == "rq1") {
  n_w8 <- sum(grepl("_w8$", cand0))
  cand0 <- cand0[!grepl("_w8$", cand0)]
  cat(sprintf("\n▶ [누수검사] RQ1: '_w8' 변수 %d개 제거 → 잔여 '_w8' 후보 %d개 (0이어야 함)\n",
              n_w8, sum(grepl("_w8$", cand0))))
} else {
  cand0 <- cand0[!grepl("^L08S108", cand0)]          # DV 계열
  cat(sprintf("\n▶ [누수검사] RQ2: 'L08S108*' 후보 %d개 (0이어야 함)\n", sum(grepl("^L08S108", cand0))))
}
cand0 <- intersect(cand0, names(full))
cdf     <- full[, cand0, drop = FALSE]
ok_miss <- vapply(cdf, function(x) mean(is.na(x)) < MISS_THR, logical(1))
ok_var  <- vapply(cdf, function(x) isTRUE(var(x, na.rm = TRUE) > 0), logical(1))
candA   <- cand0[ok_miss & ok_var]
cat(sprintf("▶ A안 후보: %d개 (탈락 — 결측률 %d / 무분산 %d)\n",
            length(candA), sum(!ok_miss), sum(ok_miss & !ok_var)))

admin <- c("Y16SID", "Y16AID", "W1", "yy")
if (TARGET_DV == "rq2") admin <- c(admin, "y_use")
varsB <- drop_const(intersect(all_theory, names(full)), full)
nonA  <- full[, candA, drop = FALSE]
nonB  <- full[, varsB, drop = FALSE]
adm   <- full[, admin, drop = FALSE]
if (TARGET_DV == "rq2") adm$y_use <- full$y_use
adfA  <- bind_cols(adm, nonA); adfB <- bind_cols(adm, nonB)
set.seed(SEED); test_sch <- sample(schools, floor(0.5 * length(schools)))
adfA$is_test <- adfA$Y16AID %in% test_sch
cat(sprintf("▶ 학교 50:50 분할: 훈련 %d개교(N=%d) + 검증 %d개교(N=%d) = %d개교\n",
            length(schools) - length(test_sch), sum(!adfA$is_test),
            length(test_sch), sum(adfA$is_test), length(schools)))
6. 결측 대체 (MICE CART, m=1)
quickpred(mincor=0.1)로 예측자 행렬을 줄이고 분류·회귀나무 방식으로 한 벌 대체한 뒤 남은 칸은 중앙값으로 메웁니다. 종속변수와 식별자(keep)는 대체 모형에서 빠집니다. 원고는 이 대체가 분할 전에 일괄로 이루어져 검증 표본 설명량이 낙관적일 수 있다고 적었습니다.
# ── (7) 결측 대체 ────────────────────────────────────────────────────────────
cat(sprintf("\n▶ 결측대체: %s\n", ifelse(USE_MICE, "MICE(CART, m=1, maxit=5)", "중앙값")))
impute_df <- function(df, keep) {
  X <- df %>% select(-any_of(keep))
  if (USE_MICE) {
    pm <- mice::quickpred(X, mincor = 0.1)
    im <- mice::mice(X, m = 1, method = "cart", predictorMatrix = pm, seed = SEED, printFlag = FALSE)
    X  <- mice::complete(im, 1)
  }
  X <- X %>% mutate(across(everything(), ~ ifelse(is.na(.), median(., na.rm = TRUE), .)))
  bind_cols(df %>% select(any_of(keep)), X)
}
keepA <- c(admin, "is_test")
t0 <- proc.time()["elapsed"]
adfA <- impute_df(adfA, keepA); adfB <- impute_df(adfB, admin)
cat(sprintf("  대체 완료 %s | 잔여 결측 A=%d / B=%d\n", fmt_sec(proc.time()["elapsed"] - t0),
            sum(is.na(adfA)), sum(is.na(adfB))))
7. 상관 .7·분산팽창계수 5 필터 함수
상관 필터는 우선순위(LASSO 계수 절댓값 순) 앞쪽 변수를 남기고 뒤쪽을 뺍니다. 분산팽창계수 필터는 가장 큰 변수를 하나씩 빼며 다시 적합합니다.
remove_high_cor <- function(M, priority, thr = 0.7) {
  v <- colnames(M); keep <- c(priority[priority %in% v], setdiff(v, priority))
  cm <- cor(M[, keep, drop = FALSE], use = "pairwise.complete.obs"); rm_ <- character(0)
  for (i in seq_along(keep)) if (!keep[i] %in% rm_)
    for (j in seq_along(keep)) if (i < j && !keep[j] %in% rm_ &&
        !is.na(cm[keep[i], keep[j]]) && abs(cm[keep[i], keep[j]]) > thr) rm_ <- c(rm_, keep[j])
  setdiff(keep, rm_)
}
remove_high_vif_lm <- function(fit0, design, outcome, thr = 5, maxit = 30) {
  fit <- fit0; it <- 0
  repeat { it <- it + 1; vf <- tryCatch(car::vif(fit), error = function(e) NULL)
    if (is.null(vf)) break; if (is.matrix(vf)) vf <- vf[, 1]
    if (max(vf) <= thr || it > maxit) break
    worst <- names(which.max(vf)); tm <- setdiff(attr(terms(fit), "term.labels"), worst)
    if (!length(tm)) break
    fit <- svyglm(as.formula(paste(outcome, "~", paste(tm, collapse = "+"))),
                  design = design, family = gaussian())
  }; fit
}
8. A안 Post-LASSO: cv.glmnet → 필터 → 검증 표본 집락 회귀 → BH
훈련 표본에서 10겹 교차검증 λ.min으로 LASSO를 적합하고, 선택 변수를 검증 표본에서 학교 집락 보정 회귀로 다시 추정합니다. BH 보정값(q)을 함께 저장합니다.
# ── (8) A안 Post-LASSO ───────────────────────────────────────────────────────
cat("\n===== A안: Post-LASSO (gaussian) =====\n")
X <- as.matrix(adfA %>% select(-any_of(keepA)))
X <- X[, apply(X, 2, function(c) var(c, na.rm = TRUE) > 0), drop = FALSE]
y <- adfA$yy; tf <- adfA$is_test
cv  <- cv.glmnet(X[!tf, ], y[!tf], family = "gaussian", alpha = 1, nfolds = 10, standardize = TRUE)
cf  <- coef(cv, s = cv$lambda.min)
sel <- setdiff(rownames(cf)[as.matrix(cf)[, 1] != 0], "(Intercept)")
predte <- as.numeric(predict(cv, newx = X[tf, ], s = "lambda.min"))
cvr2 <- 1 - min(cv$cvm) / var(y[!tf]); ter2 <- wr2(y[tf], predte); termse <- rmse(y[tf], predte)
cat(sprintf("▶ LASSO 선택(λ.min) %d개 | 훈련 CV R²≈%.4f | 검증표본 R²=%.4f, RMSE=%.4f\n",
            length(sel), cvr2, ter2, termse))

sigA <- data.frame()
if (length(sel) >= 2) {
  prio  <- names(sort(abs(as.matrix(cf)[sel, 1]), decreasing = TRUE))
  surv  <- remove_high_cor(as.data.frame(X[tf, sel, drop = FALSE]), prio)
  surv2 <- drop_const(surv, adfA)
  desA  <- svydesign(id = ~Y16AID, weights = ~W1, data = adfA, nest = TRUE)
  f0    <- svyglm(as.formula(paste("yy ~", paste(surv2, collapse = "+"))),
                  design = subset(desA, is_test), family = gaussian())
  fA    <- remove_high_vif_lm(f0, subset(desA, is_test), "yy")
  co    <- summary(fA)$coefficients
  sigA  <- data.frame(변수 = rownames(co), 라벨 = sapply(rownames(co), labof),
    계수 = round(co[, 1], 4), SE = round(co[, 2], 4), t = round(co[, 3], 3),
    p = round(co[, 4], 4), row.names = NULL) %>% filter(변수 != "(Intercept)") %>% arrange(p)
  sigA$q_BH <- round(p.adjust(sigA$p, method = "BH"), 4)   # 후선택 추론(BH-FDR), 105:88 참조
  cat(sprintf("▶ r>.7 제거 후 %d개 → VIF>5 제거 후 %d개 | 검증표본 유의(p<.05) %d개\n",
              length(surv2), length(attr(terms(fA), "term.labels")), sum(sigA$p < 0.05)))
  print(head(sigA[sigA$p < 0.05, ], 25), row.names = FALSE)
}
9. B안 위계 회귀와 ΔR²
M1부터 M4까지 누적 투입하며 R²와 증분(ΔR²)을 기록합니다. 설계는 svydesign(id=~Y16AID)로 학교 집락만 반영하고 가중치는 1(비가중)입니다.
# ── (9) B안 위계 선형회귀 ────────────────────────────────────────────────────
cat("\n===== B안: 위계 선형회귀 (gaussian, 집락 Y16AID·비가중) =====\n")
desB <- svydesign(id = ~Y16AID, weights = ~W1, data = adfB, nest = TRUE)
av <- function(v) drop_const(intersect(v, names(adfB)), adfB)
a1 <- av(vars_m1); a2 <- av(vars_m2); a3 <- av(vars_m3); a4 <- av(vars_m4)
blocks <- list(M1 = a1, M2 = c(a1, a2), M3 = c(a1, a2, a3), M4 = c(a1, a2, a3, a4))
hier <- data.frame(); prevR <- 0; fitM4 <- NULL
for (nm in names(blocks)) {
  vv <- unique(blocks[[nm]]); if (!length(vv)) next
  fit <- svyglm(as.formula(paste("yy ~", paste(vv, collapse = "+"))), design = desB, family = gaussian())
  if (nm == "M4") fitM4 <- fit
  yh <- as.numeric(predict(fit, type = "response"))
  R2 <- wr2(adfB$yy, yh)
  hier <- rbind(hier, data.frame(모형 = nm, 투입변수 = length(vv), R2 = round(R2, 4),
    수정R2 = round(adjr2(R2, nrow(adfB), length(vv)), 4), ΔR2 = round(R2 - prevR, 4),
    RMSE = round(rmse(adfB$yy, yh), 4)))
  prevR <- R2
}
print(hier, row.names = FALSE)

tagof <- function(v) ifelse(v %in% vars_m1, "M1.가정배경",
                     ifelse(v %in% vars_m2, "M2.고교시기",
                     ifelse(v %in% vars_m3, "M3.대학·노동",
                     ifelse(v %in% vars_m4, "M4.AI이용·기대", "-"))))
sigB <- data.frame(); fullB <- data.frame()
if (!is.null(fitM4)) {
  co <- summary(fitM4)$coefficients; ci <- confint(fitM4)
  fullB <- data.frame(변수 = rownames(co), 라벨 = sapply(rownames(co), labof),
    블록 = tagof(rownames(co)), 계수 = round(co[, 1], 4), SE = round(co[, 2], 4),
    t = round(co[, 3], 3), p = round(co[, 4], 4),
    CI_low = round(ci[, 1], 4), CI_high = round(ci[, 2], 4), row.names = NULL) %>%
    filter(변수 != "(Intercept)")
  sigB <- fullB %>% arrange(p)
  cat(sprintf("\n▶ B안 M4 유의(p<.05) %d개 / 전체 %d개\n", sum(sigB$p < 0.05), nrow(sigB)))
  print(head(sigB[sigB$p < 0.05, ], 30), row.names = FALSE)
}
10. 50회 반복 분할과 교차 확인 핵심 변수
회차마다 시드 2000+r로 학교를 다시 나누고, 훈련 표본 중앙값으로 결측을 메운 뒤 LASSO 선택만 되풀이합니다. 상관·분산팽창계수 제거와 검증 회귀는 되풀이하지 않습니다. 마지막 줄의 세 집합 교집합이 교차 확인 핵심 변수입니다.
# ── (10) Multisplit 안정성 ───────────────────────────────────────────────────
cat(sprintf("\n===== Multisplit %d회 안정성 (회차별 훈련표본 중앙값 대체) =====\n", N_REPEAT))
acc <- character(0); t0 <- proc.time()["elapsed"]
Xr0 <- as.data.frame(nonA); yr <- full$yy; aid <- full$Y16AID
for (r in seq_len(N_REPEAT)) {
  set.seed(2000 + r)
  tsr <- aid %in% sample(schools, floor(0.5 * length(schools)))
  med_tr <- vapply(Xr0, function(col) median(col[!tsr], na.rm = TRUE), numeric(1))
  Xc <- Xr0
  for (j in seq_along(Xc)) { m <- med_tr[j]; if (is.na(m)) m <- 0
    v <- Xc[[j]]; v[is.na(v)] <- m; Xc[[j]] <- v }
  M <- as.matrix(Xc); M <- M[, apply(M, 2, function(c) var(c[!tsr]) > 0), drop = FALSE]
  cvr <- cv.glmnet(M[!tsr, ], yr[!tsr], family = "gaussian", alpha = 1, nfolds = 10, standardize = TRUE)
  pr  <- setdiff(rownames(coef(cvr, s = cvr$lambda.min))[as.matrix(coef(cvr, s = cvr$lambda.min))[, 1] != 0],
                 "(Intercept)")
  if (length(pr)) acc <- c(acc, pr)
  if (r %% 10 == 0) cat(sprintf("  [%02d/%02d] 누적 %s\n", r, N_REPEAT, fmt_sec(proc.time()["elapsed"] - t0)))
}
stab <- as.data.frame(table(acc), stringsAsFactors = FALSE) %>%
  rename(변수 = acc, 선택횟수 = Freq) %>%
  mutate(생존율 = round(선택횟수 / N_REPEAT * 100, 1), 라벨 = sapply(변수, labof)) %>%
  filter(생존율 >= SURV_PCT) %>% arrange(desc(선택횟수))
cat(sprintf("▶ 생존율 %d%% 이상: %d개\n", SURV_PCT, nrow(stab)))
print(head(stab, 30), row.names = FALSE)

# ── (11) 교차검증 핵심변수 (A안 검증유의 ∩ B안 M4 유의 ∩ 생존율≥60%) ────────
sA <- if (nrow(sigA)) gsub("\\.", "", sigA$변수[sigA$p < 0.05]) else character(0)
sB <- if (nrow(sigB)) sigB$변수[sigB$p < 0.05] else character(0)
crossv <- Reduce(intersect, list(sA, sB, stab$변수))
cat(sprintf("\n===== 교차검증 핵심 결정요인 %d개 (A∩B∩생존%d%%) =====\n", length(crossv), SURV_PCT))
if (length(crossv)) for (v in crossv) cat(sprintf("  - %-22s %s\n", v, labof(v))) else
  cat("  (없음 — 기준 미조정, 있는 그대로 보고)\n")
11. 계층 격차 검정: 표준화 SES 모형과 Bonferroni
부모 학력·아버지 소득을 표준화해 다섯 결과에 회귀하고, 결과 5 × 축 2 = 10회 검정에 Bonferroni 임곗값 .005를 적용합니다(〈표 5〉).
# ── (6) 표 G2: 표준화 SES 로지스틱/선형 (105 방식) ───────────────────────────
cat("\n============ 표 G2: 표준화 SES 효과 (per +1SD, 집락 Y16AID) ============\n")
OUTC <- list(
  list(nm = "011 동의(≥4)",   y = d$ag011,   fam = "bin"),
  list(nm = "011 평균",        y = d$y_rq1,   fam = "gau"),
  list(nm = "rq2 상위3분위",   y = d$top_rq2, fam = "bin"),
  list(nm = "rq2 평균",        y = d$y_rq2,   fam = "gau"),
  list(nm = "AI앱 사용(use)",  y = d$y_use,   fam = "bin"))
AXES2 <- list(`부모 최고학력` = d$par_edu_max, `부 월소득` = d$fa_income)
MODS  <- list(단순 = "z", `통제(성별+수도권거주)` = "z + GENDER + is_Capital")

G2 <- list()
for (o in OUTC) for (an in names(AXES2)) for (mn in names(MODS)) {
  dd <- data.frame(Y16AID = d$Y16AID, W1 = 1, y = o$y, z = zstd(AXES2[[an]]),
                   GENDER = d$GENDER, is_Capital = d$is_Capital)
  dd <- dd[complete.cases(dd), ]
  est <- NA; lo <- NA; hi <- NA; pp <- NA
  if (nrow(dd) >= 50) try({
    des <- svydesign(id = ~Y16AID, weights = ~W1, data = dd, nest = TRUE)
    fit <- svyglm(as.formula(paste("y ~", MODS[[mn]])), design = des,
                  family = if (o$fam == "bin") quasibinomial() else gaussian())
    co  <- summary(fit)$coefficients["z", ]
    if (o$fam == "bin") { est <- exp(co[1]); lo <- exp(co[1] - 1.96 * co[2]); hi <- exp(co[1] + 1.96 * co[2]) }
    else                { est <- co[1];      lo <- co[1] - 1.96 * co[2];      hi <- co[1] + 1.96 * co[2] }
    pp <- co[4]
  }, silent = TRUE)
  G2[[length(G2) + 1]] <- data.frame(결과 = o$nm, SES축 = an, 모형 = mn,
    지표 = ifelse(o$fam == "bin", "OR per +1SD", "beta per +1SD"), N = nrow(dd),
    추정치 = round(est, 3), CI_low = round(lo, 3), CI_high = round(hi, 3),
    p = round(pp, 4), Bonferroni통과_005 = ifelse(is.na(pp), NA, pp < 0.05 / BONF_M),
    row.names = NULL)
}
G2 <- bind_rows(G2)
12. 두 기울기 차이의 학교 집락 부트스트랩 400회
전망과 리터러시를 각각 z화해 부모 학력 z에 회귀하고, 기울기 절댓값의 차이를 학교 단위 재표집 400회로 구간 추정합니다(S5).
# =============================================================================
# S5. 두 기울기 차이 검정 (권고)
# =============================================================================
cat(sprintf("\n============ S5: |β₂|−|β₁| 집락 부트스트랩 %d회 ============\n", N_BOOT))
ov <- d0[!is.na(d0$y_rq1) & !is.na(d0$y_rq2) & !is.na(d0$par_edu_max) & !is.na(d0$Y16AID), ]
cat(sprintf("  7·8차 중첩 + 부모학력 비결측 N=%d | 학교 %d\n", nrow(ov), length(unique(ov$Y16AID))))
ov$z1 <- zstd(ov$y_rq1); ov$z2 <- zstd(ov$y_rq2); ov$zp <- zstd(ov$par_edu_max); ov$W1 <- 1
desO <- svydesign(id = ~Y16AID, weights = ~W1, data = ov, nest = TRUE)
c1 <- summary(svyglm(z1 ~ zp, design = desO, family = gaussian()))$coefficients["zp", ]
c2 <- summary(svyglm(z2 ~ zp, design = desO, family = gaussian()))$coefficients["zp", ]
dstat <- abs(c2[1]) - abs(c1[1])
cat(sprintf("  β₁(판단권 전망) = %.4f (SE %.4f, p=%.4g) | β₂(리터러시) = %.4f (SE %.4f, p=%.4g)\n",
            c1[1], c1[2], c1[4], c2[1], c2[2], c2[4]))

set.seed(SEED)
sch <- unique(ov$Y16AID); idxby <- split(seq_len(nrow(ov)), ov$Y16AID)
bs <- numeric(N_BOOT); b1s <- numeric(N_BOOT); b2s <- numeric(N_BOOT)
t0 <- proc.time()["elapsed"]
for (b in seq_len(N_BOOT)) {
  s  <- sample(sch, length(sch), replace = TRUE)
  ii <- unlist(idxby[as.character(s)], use.names = FALSE)
  o  <- ov[ii, ]
  p  <- zstd(o$par_edu_max); u1 <- zstd(o$y_rq1); u2 <- zstd(o$y_rq2)
  b1 <- coef(lm(u1 ~ p))[2]; b2 <- coef(lm(u2 ~ p))[2]
  b1s[b] <- b1; b2s[b] <- b2; bs[b] <- abs(b2) - abs(b1)
}
ci <- quantile(bs, c(.025, .975), na.rm = TRUE)
cat(sprintf("  |β₂|−|β₁| = %.4f | 부트스트랩 95%% CI [%.4f, %.4f] | 0 포함 %s | %s\n",
            dstat, ci[1], ci[2], ifelse(ci[1] <= 0 & ci[2] >= 0, "예", "아니오"),
            fmt_sec(proc.time()["elapsed"] - t0)))
S5 <- data.frame(
  항목 = c("β₁: 판단권 이양 전망(z) ~ 부모학력(z)", "β₂: AI 리터러시(z) ~ 부모학력(z)",
           "|β₂| − |β₁|"),
  추정치 = round(c(c1[1], c2[1], dstat), 4),
  SE_집락 = c(round(c1[2], 4), round(c2[2], 4), NA),
  p_집락 = c(round(c1[4], 4), round(c2[4], 4), NA),
  부트_CI_low = c(round(quantile(b1s, .025), 4), round(quantile(b2s, .025), 4), round(ci[1], 4)),
  부트_CI_high = c(round(quantile(b1s, .975), 4), round(quantile(b2s, .975), 4), round(ci[2], 4)),
  N = nrow(ov), 학교수 = length(sch), 부트반복 = N_BOOT, row.names = NULL)
print(S5, row.names = FALSE)
sc(S5, "S5_slope_diff.csv")
13. 종속변수 포함 다중대체 m=20과 Rubin 결합
종속변수를 대체 모형에 넣은 m=20 대체를 만들고 mice::pool로 결합합니다. 실패하면 Rubin 공식을 직접 계산하는 대안이 있습니다(S18).
impute_multi <- function(B, m, keep_dv, seed = SEED) {
  drop_cols <- if (keep_dv) setdiff(B$admin, "yy") else B$admin
  X  <- B$adfB_raw %>% select(-any_of(drop_cols))
  pm <- mice::quickpred(X, mincor = 0.1)
  me <- mice::make.method(X); me[me != ""] <- "cart"
  if (keep_dv) stopifnot(sum(is.na(X$yy)) == 0, me[["yy"]] == "")
  im <- mice::mice(X, m = m, method = me, predictorMatrix = pm, maxit = 5,
                   seed = seed, printFlag = FALSE)
  lapply(seq_len(m), function(i) {
    cm <- med_fill(mice::complete(im, i))
    out <- bind_cols(B$adfB_raw[, B$admin, drop = FALSE], cm %>% select(-any_of("yy")))
    out$par_edu_z <- zstd(out$par_edu_max)
    out
  })
}
rubin_manual <- function(fits) {
  Q <- sapply(fits, coef); U <- sapply(fits, function(f) diag(vcov(f)))
  m <- length(fits)
  qbar <- rowMeans(Q); ubar <- rowMeans(U); b <- apply(Q, 1, var)
  tt <- ubar + (1 + 1 / m) * b
  lam <- (1 + 1 / m) * b / tt; lam[!is.finite(lam)] <- 0; lam <- pmax(lam, 1e-8)
  dfcom <- df.residual(fits[[1]])
  df_old <- (m - 1) / lam^2
  df_obs <- (dfcom + 1) / (dfcom + 3) * dfcom * (1 - lam)
  dfa <- df_old * df_obs / (df_old + df_obs)
  se <- sqrt(tt); tv <- qbar / se
  data.frame(term = names(qbar), estimate = qbar, std.error = se,
             statistic = tv, p.value = 2 * pt(-abs(tv), dfa), fmi = lam, row.names = NULL)
}
pool_fits <- function(fits) {
  out <- NULL
  try({ ps <- summary(mice::pool(mice::as.mira(fits)))
    out <- data.frame(term = as.character(ps$term), estimate = ps$estimate, std.error = ps$std.error,
                      statistic = ps$statistic, p.value = ps$p.value, fmi = NA_real_, row.names = NULL)
    attr(out, "how") <- "mice::pool" }, silent = TRUE)
  if (is.null(out)) { out <- rubin_manual(fits); attr(out, "how") <- "Rubin 수식 직접구현" }
  rownames(out) <- out$term
  out
}

cat("\n▶ 분석자료 구성\n")
B1 <- build_dv("rq1"); B2 <- build_dv("rq2")
cat(sprintf("  RQ1 N=%d | RQ2 N=%d\n", B1$N, B2$N))
cat(sprintf("  M4a(345번 이용빈도, 4점) = %s\n", paste(B1$m4a, collapse = ", ")))
cat(sprintf("  M4b RQ1(346~348번 태도, 6점) = %s\n", paste(B1$m4b, collapse = ", ")))
cat(sprintf("  M4b RQ2 = 위 + %s\n", paste(setdiff(B2$m4b, B1$m4b), collapse = ", ")))
cat("\n  ※ [중대 1 관련 설문 원문 기록] 7차 설문 348번 도입문은 '다음에 대해 얼마나 동의하십니까?'이고,\n")
cat("     1) L08S107013 = '새로운 과학기술의 발견은 미래 인류의 삶의 질을 향상시킬 것이다'\n")
cat("     2) L08S107014 = '새로운 과학기술이 가져다 주는 혜택은 소수에게 독점될 것이다'\n")
cat("     3) L08S107015 = '인간은 인공지능이나 로봇이 대체할 수 없는 능력을 갖고 있다'\n")
cat("     즉 013·014 는 AI 를 지칭하지 않는 '새로운 과학기술' 일반 문항이다(015 만 AI 를 지칭).\n")
14. 문항별 계층 기울기와 판단권 문항의 잔차
판단권 문항을 일자리 감소·개인정보 유출·혜택 독점에 회귀한 잔차의 계층 기울기입니다. 원고의 −.063이 여기서 나옵니다.
# ── (c) 011 의 잔차 ─────────────────────────────────────────────────────────
cat("\n---- (c) 011 을 009·010·014 에 회귀한 잔차의 계층 기울기 ----\n")
VR  <- sprintf("L08S107%03d_w7", c(9, 10, 14))
okr <- complete.cases(d0[, c("y_rq1", VR)])
fr  <- lm(as.formula(paste("y_rq1 ~", paste(VR, collapse = "+"))), data = d0[okr, ])
d0$resid011 <- NA_real_; d0$resid011[okr] <- as.numeric(residuals(fr))
cat(sprintf("  잔차 산출 lm: N=%d | R²=%.4f | 계수 %s\n", sum(okr), summary(fr)$r.squared,
            paste(sprintf("%s=%.3f", VR, coef(fr)[VR]), collapse = ", ")))
rc1 <- zslope(d0, "resid011")
rc2 <- zslope(d0, "resid011", extra = c("GENDER", "is_Capital"))
S23 <- rbind(S23,
  row_slope("④ 011 잔차(009·010·014 통제)", "resid011", "잔차, 통제 없음", rc1, -.063),
  row_slope("④ 011 잔차(009·010·014 통제)", "resid011_gc", "잔차, 성별·수도권 거주 추가 통제", rc2, -.052))
print(tail(S23, 2)[, c("변수", "라벨", "N", "표준화기울기", "SE", "t", "p", "위원장값", "차이", "일치_pm002")],
      row.names = FALSE)
15. 상관 .7 필터의 부산물 점검
8차 재직 여부와 디지털 과업 수의 상관을 원자료·대체본·검증 표본에서 따로 계산합니다(S24).
# ── r(emp_w8, digital_tasks) — rq2 분석표본 원자료 ──────────────────────────
cat("\n---- r(emp_w8, digital_tasks): RQ2 분석표본(원자료, 10_main.R 산식) ----\n")
F2 <- A2$full
r_raw  <- cor(F2$emp_w8, F2$digital_tasks, use = "complete.obs")
r_imp  <- cor(A2$adfA$emp_w8, A2$adfA$digital_tasks)
r_test <- cor(A2$adfA$emp_w8[A2$tf], A2$adfA$digital_tasks[A2$tf])
cat(sprintf("  원자료 전체 분석표본 N=%d → r=%.4f\n", sum(complete.cases(F2[, c("emp_w8", "digital_tasks")])), r_raw))
cat(sprintf("  대체본 전체 N=%d → r=%.4f | 대체본 검증표본 N=%d → r=%.4f (필터가 실제로 보는 값)\n",
            nrow(A2$adfA), r_imp, sum(A2$tf), r_test))
cat(sprintf("  위원장 값 .7645 와의 차이: 원자료 %+.4f / 검증표본 %+.4f\n", r_raw - .7645, r_test - .7645))
S24 <- rbind(S24, data.frame(구분 = "③ r(emp_w8, digital_tasks)", DV = "RQ2",
  항목 = c("원자료 분석표본", "대체본 전체", "대체본 검증표본(필터 적용 대상)", "위원장 재계산값"),
  라벨 = "8차 재직 여부 ↔ 업무 디지털 활용 과업 수",
  값 = round(c(r_raw, r_imp, r_test, .7645), 4), SE = NA_real_, p = NA_real_,
  N = c(sum(complete.cases(F2[, c("emp_w8", "digital_tasks")])), nrow(A2$adfA), sum(A2$tf), NA),
  비고 = "", row.names = NULL))
16. 잔존 역확률 가중(IPW)
잔존 로지스틱의 예측 확률로 안정화 가중치를 만들고 1~99분위에서 절단합니다(S22).
mk_ipw <- function(yv) {
  f  <- svyglm(as.formula(paste(yv, "~ par_edu3 + fa_inc3 + hs3 + gr4 + GENDER + is_Capital")),
               design = desL, family = quasibinomial())
  ph <- as.numeric(predict(f, type = "response"))
  sw <- mean(L[[yv]]) / ph                    # 안정화 가중치
  sw[L[[yv]] == 0] <- NA                      # 탈락자는 분석표본에 없다
  q  <- quantile(sw, TRIM, na.rm = TRUE)
  swt <- pmin(pmax(sw, q[1]), q[2])           # 1~99분위 절단
  cat(sprintf("  [%s] 잔존확률 범위 %.3f~%.3f | 가중치 평균 %.3f SD %.3f 최소 %.3f 최대 %.3f (절단 전 최대 %.3f)\n",
              yv, min(ph), max(ph), mean(swt, na.rm = TRUE), sd(swt, na.rm = TRUE),
              min(swt, na.rm = TRUE), max(swt, na.rm = TRUE), max(sw, na.rm = TRUE)))
  setNames(swt, L$Y16SID)
}
w7 <- mk_ipw("ret7"); w8 <- mk_ipw("ret8")
d$ipw7 <- unname(w7[as.character(d$Y16SID)])
d$ipw8 <- unname(w8[as.character(d$Y16SID)])
스크립트 대장
| 번호 | 파일 | 역할 | 실행 시간(로그) |
|---|---|---|---|
| 00 | 00_build.R | 1~8차 long 원자료 → 1인 1행 wide, 종속변수·파생변수, 변수사전.csv | 23.3초 |
| 10 | 10_main.R | 본분석: A안 Post-LASSO × B안 위계 회귀 × 50회 반복 분할, TARGET_DV=rq1/rq2 | 판단권 35분57초 / 리터러시 30분37초 (MICE가 대부분) |
| 20 | 20_gradient.R | 계층 격차 표(G1~G3)·강건성(R1~R4)·〈그림 1〉 | 1분11초 |
| 40 | 40_supp.R | S1~S9(결측률, 대체 방식 비교, 부모 학력 궤적, 탈락, 기울기 차이 부트스트랩 등) | 28분02초 |
| 41 | 41_supp_extra.R | S10(판단권 상관)·S11(수도권×대학 유형 카이제곱) | — |
| 42 | 42_supp_round_d.R | S12~S17, R3 정합(M3 분리·앱 사용·블록 밖 안정 변수·결측 집단) | 3분04초 |
| 43 | 43_supp_round_e.R | S18~S20(종속변수 포함 m=20, M4 분리, 소프트스킬 통제) | 27분18초 |
| 44 | 44_supp_round_f.R | S21(문항 상관)·S22(IPW) | 2초 |
| 45 | 45_supp_round_g.R | S23(문항별 기울기·잔차·서열 로짓)·S24(필터 부산물) | 52분16초 |
재현: 시드 2026(반복 분할 회차별 2000+r) · R 4.5.2 · 원자료와 개인 수준 데이터는 비공개
용어
가나다·알파벳 순입니다. 본문에 점선이 그어진 낱말을 누르면 같은 설명이 아래에서 열립니다.
변수 사전
분석에 들어간 변수의 원자료 코드, 설문 문항, 재코딩입니다. AI 문항(7차 345~348번, 8차 345~347번)은 설문지 원문과 대조했고, 나머지는 코드북 라벨(변수사전.csv)입니다.
변수 45개 · 설문지 원문 확인 20개 · 코드북 라벨 25개
L08S107011
[도입문] 10년 후 미래에 AI가 가져올 부정적 영향에 대해 어느 정도 동의하십니까? — AI로 인해 인간은 중요한 선택과 결정을 하지 않을 것이다
- 1 = 전혀 그렇지 않다
- 2 = 그렇지 않다
- 3 = 약간 그렇지 않다
- 4 = 약간 그렇다
- 5 = 그렇다
- 6 = 매우 그렇다
분석 코딩: 주 종속변수(y_rq1). 6점 그대로 선형 모형, 4점 이상=동의(64.2%). N=7,742, 평균 3.78(SD 1.27).
차수별 변수: Y23SS01011(7차)
출처: KEEP2_7차년도_설문지_전문(텍스트추출).txt / 7차 설문지(변수명 포함본) HWP
L08S108007
[도입문] 귀하는 다음에 대해 알고 있습니까? — 나는 AI 기술의 강점과 한계를 알고 있다
- 1 = 전혀 그렇지 않다
- 2 = 그렇지 않다
- 3 = 약간 그렇지 않다
- 4 = 약간 그렇다
- 5 = 그렇다
- 6 = 매우 그렇다
분석 코딩: 리터러시(y_rq2) 세 문항 중 첫째. 문항 평균 3.81.
차수별 변수: Y24SS01007(8차)
출처: KEEP2_8차년도_설문지_전문(텍스트추출).txt / 8차 설문지(변수명 포함본) HWP
L08S108008
나는 AI 시대에 가져야 할 윤리적 의무를 알고 있다
- 1 = 전혀 그렇지 않다
- 2 = 그렇지 않다
- 3 = 약간 그렇지 않다
- 4 = 약간 그렇다
- 5 = 그렇다
- 6 = 매우 그렇다
분석 코딩: 리터러시(y_rq2) 세 문항 중 둘째. 문항 평균 3.68.
차수별 변수: Y24SS01008(8차)
출처: KEEP2_8차년도_설문지_전문(텍스트추출).txt / 8차 설문지(변수명 포함본) HWP
L08S108009
나는 AI 기술을 사용하는 과정에서 지켜야 할 법적 책임을 알고 있다
- 1 = 전혀 그렇지 않다
- 2 = 그렇지 않다
- 3 = 약간 그렇지 않다
- 4 = 약간 그렇다
- 5 = 그렇다
- 6 = 매우 그렇다
분석 코딩: 리터러시(y_rq2) 세 문항 중 셋째. 문항 평균 3.45로 가장 낮음. 세 문항 평균 α=.914, N=7,507.
차수별 변수: Y24SS01009(8차)
출처: KEEP2_8차년도_설문지_전문(텍스트추출).txt / 8차 설문지(변수명 포함본) HWP
L08S108001
귀하는 AI 앱(프로그램)을 활용해본 경험이 있습니까?
- 1 = 예 (⇒ 345-1번 문항으로)
- 2 = 아니오 (⇒ 346번 문항으로)
분석 코딩: y_use = 1[응답=1]. 39.2%(2,951명). 345-1(002~006)은 경험자만 응답하는 구조적 결측이라 종속변수에서 뺐습니다.
차수별 변수: Y24SS01001(8차)
출처: KEEP2_8차년도_설문지_전문(텍스트추출).txt / 8차 설문지(변수명 포함본) HWP
L08S107012
AI로 인해 인간과 인간 사이의 유대감이 약화될 것이다
- 1 = 전혀 그렇지 않다
- 2 = 그렇지 않다
- 3 = 약간 그렇지 않다
- 4 = 약간 그렇다
- 5 = 그렇다
- 6 = 매우 그렇다
분석 코딩: 민감도 종속변수(y_rq1b = 011·012 평균, N=7,743, r=.55)의 한 성분. 리터러시 분석 M4에 투입.
차수별 변수: Y23SS01012(7차)
출처: KEEP2_7차년도_설문지_전문(텍스트추출).txt / 7차 설문지(변수명 포함본) HWP
L08S107001
[도입문] 현재 다음의 인공지능(AI) 기반 서비스를 얼마나 자주 이용하십니까? — 인공지능 기반 번역 서비스 (구글 번역기, 네이버 파파고)
- 1 = 전혀 이용하지 않는다
- 2 = 거의 이용하지 않는다
- 3 = 가끔 이용한다
- 4 = 자주 이용한다
분석 코딩: M4 이용 빈도(4점 그대로 투입). 판단권 교차 확인 핵심 변수에 넷 모두 포함.
차수별 변수: Y23SS01001(7차)
출처: KEEP2_7차년도_설문지_전문(텍스트추출).txt / 7차 설문지(변수명 포함본) HWP
L08S107002
[도입문] 현재 다음의 인공지능(AI) 기반 서비스를 얼마나 자주 이용하십니까? — 인공지능 기반 추천 서비스 (유튜브나 넷플릭스 컨텐츠 추천)
- 1 = 전혀 이용하지 않는다
- 2 = 거의 이용하지 않는다
- 3 = 가끔 이용한다
- 4 = 자주 이용한다
분석 코딩: M4 이용 빈도(4점 그대로 투입). 판단권 교차 확인 핵심 변수에 넷 모두 포함.
차수별 변수: Y23SS01002(7차)
출처: KEEP2_7차년도_설문지_전문(텍스트추출).txt / 7차 설문지(변수명 포함본) HWP
L08S107003
[도입문] 현재 다음의 인공지능(AI) 기반 서비스를 얼마나 자주 이용하십니까? — 인공지능 기반 얼굴/이미지 인식 서비스 (안면 인식 인증 등 증강현실 촬영)
- 1 = 전혀 이용하지 않는다
- 2 = 거의 이용하지 않는다
- 3 = 가끔 이용한다
- 4 = 자주 이용한다
분석 코딩: M4 이용 빈도(4점 그대로 투입). 판단권 교차 확인 핵심 변수에 넷 모두 포함.
차수별 변수: Y23SS01003(7차)
출처: KEEP2_7차년도_설문지_전문(텍스트추출).txt / 7차 설문지(변수명 포함본) HWP
L08S107004
[도입문] 현재 다음의 인공지능(AI) 기반 서비스를 얼마나 자주 이용하십니까? — 인공지능 기반 음성인식 서비스 (인공지능 스피커, 스마트폰 음성인식)
- 1 = 전혀 이용하지 않는다
- 2 = 거의 이용하지 않는다
- 3 = 가끔 이용한다
- 4 = 자주 이용한다
분석 코딩: M4 이용 빈도(4점 그대로 투입). 판단권 교차 확인 핵심 변수에 넷 모두 포함.
차수별 변수: Y23SS01004(7차)
출처: KEEP2_7차년도_설문지_전문(텍스트추출).txt / 7차 설문지(변수명 포함본) HWP
L08S107005
[도입문] 10년 후 미래에 AI가 가져올 긍정적 영향에 대해 어느 정도 동의하십니까? — AI로 인해 보다 개별화된 학습이 가능해질 것이다
- 1 = 전혀 그렇지 않다
- 2 = 그렇지 않다
- 3 = 약간 그렇지 않다
- 4 = 약간 그렇다
- 5 = 그렇다
- 6 = 매우 그렇다
분석 코딩: M4 AI 긍정 기대(6점).
차수별 변수: Y23SS01005(7차)
출처: KEEP2_7차년도_설문지_전문(텍스트추출).txt / 7차 설문지(변수명 포함본) HWP
L08S107006
AI로 인해 보다 효율적 업무 수행이 가능해질 것이다
- 1 = 전혀 그렇지 않다
- 2 = 그렇지 않다
- 3 = 약간 그렇지 않다
- 4 = 약간 그렇다
- 5 = 그렇다
- 6 = 매우 그렇다
분석 코딩: M4 AI 긍정 기대(6점).
차수별 변수: Y23SS01006(7차)
출처: KEEP2_7차년도_설문지_전문(텍스트추출).txt / 7차 설문지(변수명 포함본) HWP
L08S107007
AI로 인해 새로운 일자리 출현이 가능해질 것이다
- 1 = 전혀 그렇지 않다
- 2 = 그렇지 않다
- 3 = 약간 그렇지 않다
- 4 = 약간 그렇다
- 5 = 그렇다
- 6 = 매우 그렇다
분석 코딩: M4 AI 긍정 기대(6점).
차수별 변수: Y23SS01007(7차)
출처: KEEP2_7차년도_설문지_전문(텍스트추출).txt / 7차 설문지(변수명 포함본) HWP
L08S107008
AI로 인해 인간의 외로움 해소가 가능해질 것이다
- 1 = 전혀 그렇지 않다
- 2 = 그렇지 않다
- 3 = 약간 그렇지 않다
- 4 = 약간 그렇다
- 5 = 그렇다
- 6 = 매우 그렇다
분석 코딩: M4 AI 긍정 기대(6점).
차수별 변수: Y23SS01008(7차)
출처: KEEP2_7차년도_설문지_전문(텍스트추출).txt / 7차 설문지(변수명 포함본) HWP
L08S107009
AI로 인해 일자리가 감소할 것이다
- 1 = 전혀 그렇지 않다
- 2 = 그렇지 않다
- 3 = 약간 그렇지 않다
- 4 = 약간 그렇다
- 5 = 그렇다
- 6 = 매우 그렇다
분석 코딩: M4 AI 위험(일자리 감소). 판단권과 r=.294.
차수별 변수: Y23SS01009(7차)
출처: KEEP2_7차년도_설문지_전문(텍스트추출).txt / 7차 설문지(변수명 포함본) HWP
L08S107010
AI로 인해 개인정보 유출 및 사생활이 침해될 것이다
- 1 = 전혀 그렇지 않다
- 2 = 그렇지 않다
- 3 = 약간 그렇지 않다
- 4 = 약간 그렇다
- 5 = 그렇다
- 6 = 매우 그렇다
분석 코딩: M4 AI 위험(개인정보 유출). 판단권과 r=.320, 최종 모형 계수 .278.
차수별 변수: Y23SS01010(7차)
출처: KEEP2_7차년도_설문지_전문(텍스트추출).txt / 7차 설문지(변수명 포함본) HWP
L08S107013
[도입문] 다음에 대해 얼마나 동의하십니까? — 새로운 과학기술의 발견은 미래 인류의 삶의 질을 향상시킬 것이다
- 1 = 전혀 그렇지 않다
- 2 = 그렇지 않다
- 3 = 약간 그렇지 않다
- 4 = 약간 그렇다
- 5 = 그렇다
- 6 = 매우 그렇다
분석 코딩: M4 과학기술 일반 기대. AI가 아니라 과학기술 일반을 가리키므로 따로 표기. 판단권과 r=.011.
차수별 변수: Y23SS01013(7차)
출처: KEEP2_7차년도_설문지_전문(텍스트추출).txt / 7차 설문지(변수명 포함본) HWP
L08S107014
새로운 과학기술이 가져다 주는 혜택은 소수에게 독점될 것이다
- 1 = 전혀 그렇지 않다
- 2 = 그렇지 않다
- 3 = 약간 그렇지 않다
- 4 = 약간 그렇다
- 5 = 그렇다
- 6 = 매우 그렇다
분석 코딩: M4 과학기술 일반 위험(혜택 독점). 판단권과 r=.332, 최종 모형 계수 .245.
차수별 변수: Y23SS01014(7차)
출처: KEEP2_7차년도_설문지_전문(텍스트추출).txt / 7차 설문지(변수명 포함본) HWP
L08S107015
인간은 인공지능이나 로봇이 대체할 수 없는 능력을 갖고 있다
- 1 = 전혀 그렇지 않다
- 2 = 그렇지 않다
- 3 = 약간 그렇지 않다
- 4 = 약간 그렇다
- 5 = 그렇다
- 6 = 매우 그렇다
분석 코딩: 판단권과 r=.006이어서 합산하지 않음. 판단권 분석에는 기술통계만, 리터러시 분석 M4에는 투입(β=0.036, p=.028).
차수별 변수: Y23SS01015(7차)
출처: KEEP2_7차년도_설문지_전문(텍스트추출).txt / 7차 설문지(변수명 포함본) HWP
L08S109001~006
평소 업무를 수행할 때 컴퓨터, 태블릿, 휴대폰 등을 활용하여 다음과 같은 일을 하십니까? (정보검색·오피스·전문 프로그램·자동화 기기·디지털 효율화·새 비즈니스 모델 6항목)
- 1 = 수행하지 않는다
- 2 = 수행한다
분석 코딩: digital_tasks = 「수행한다(2)」 개수(0~6), 비재직은 0. emp_w8 = 이 문항 응답 여부(8차 재직). 둘의 상관 .765. 리터러시 분석 M3에만 투입.
차수별 변수: Y24SS02001~006(8차)
출처: KEEP2_8차년도_설문지_전문(텍스트추출).txt / 8차 설문지(변수명 포함본) HWP
univ_type
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: 1·2·3=전문대(univ_junior), 4·5·6·7=4년제·기타(기준). 대학 유형·계열·소재지가 모두 결측이면 미진학(univ_none). 판단권 분석은 2~7차 마지막 응답.
차수별 변수: L08U102001(2~8차 마지막 비결측)
출처: 변수사전.csv / 10_main.R (3-2)절
univ_major
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: 계열 코드 첫자리 4·5·6(공학·자연·의약)=1(stem). 미진학은 0.
차수별 변수: L08U102003(2~8차 마지막 비결측)
출처: 변수사전.csv / 10_main.R (3-2)절
univ_region
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: 소재지 코드 1·4·8(서울·인천·경기)=1(univ_capital). 미진학은 0.
차수별 변수: L08U102006(2~8차 마지막 비결측)
출처: 변수사전.csv / 10_main.R (3-2)절
L08J302012
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: emp_w7 = 응답 여부(7차 취업). 판단권 분석 M3. 종속변수와 같은 차수.
차수별 변수: (7차) 주된 일자리-임금근로자 종사상 지위
출처: 변수사전.csv
GENDER
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
- 1 = 남
- 2 = 여
분석 코딩: M1. 리터러시 최종 모형 여성 −0.083(p<.05).
차수별 변수: GENDER(1차)
출처: 변수사전.csv
L08F104021 / L08F104051
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
- 1 = 무학
- 2 = 초졸
- 3 = 중졸
- 4 = 고졸
- 5 = 전문대졸
- 6 = 대졸
- 7 = 석사
- 8 = 박사
분석 코딩: par_edu_max = 두 값 중 높은 값(1~8, 등간 투입). 3범주: 1~4 고졸 이하 / 5 전문대 / 6~8 4년제 이상. 판단권 표본 결측 7.52%.
차수별 변수: (2차) 남성·여성보호자 최종학력
출처: 변수사전.csv / 20_gradient.R (3)절 / 논문 〈표 1〉 주
L08F104027
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: fa_income = 1~11 소득 구간 서열 코드(등간 투입). 3범주는 분위수 경계(하 2,982·중 1,051·상 1,526명). 판단권 표본 결측 28.2%.
차수별 변수: (2차) 남성보호자 월평균 소득
출처: 변수사전.csv / 논문 3장 3)
L08F101024
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: is_Capital = 거주 지역 코드 1·4·8이면 1(수도권). 고교 시기 거주지로, 대학 소재지와 다름(r=.478).
차수별 변수: (2차) 현재 거주 지역
출처: 변수사전.csv / 00_build.R (5)절
L08F101025
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: dosi_gyumo(1 특별시 ~ 4 읍면).
차수별 변수: (2차) 현재 거주하는 지역 규모
출처: 변수사전.csv
L08F103001
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: M1 가정생활 만족도(5점).
차수별 변수: (1+2차) 가정생활 전반 만족도
출처: 변수사전.csv
naesin_avg
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: M2. naesin_avg = 5과목 내신등급 평균(1=최상~9=최하).
차수별 변수: L08H102065~069(고3 1학기 5과목)
출처: 변수사전.csv(코드북 라벨) / 10_main.R
L08H102153
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: M2. 등급이어서 음의 계수가 성적이 좋을수록 높음을 뜻함. 리터러시 최종 −0.041(p<.001).
차수별 변수: (1차) 중3 성적(등급)
출처: 변수사전.csv(코드북 라벨) / 10_main.R
L08H102042
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: M2. 수학 자신감(5점).
차수별 변수: (1차) 수학-잘한다
출처: 변수사전.csv(코드북 라벨) / 10_main.R
L08H102048
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: M2. 과학 자신감(5점).
차수별 변수: (1차) 과학 영역-잘한다
출처: 변수사전.csv(코드북 라벨) / 10_main.R
L08H101002
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: M2. 1 일반고(기준) / 3·8 특성화·마이스터 = hs_voc / 2·4·5·6·7 자율·과학·외국어국제·예술·체육 = hs_elite.
차수별 변수: (1차) 재학 중인 고등학교 유형
출처: 변수사전.csv(코드북 라벨) / 10_main.R
L08H104150
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: M2. 원 단위 → edu_cost10 = 값/100,000(10만 원 단위). 판단권 최종 −.007(p=.046).
차수별 변수: (2차) 진학관련 월평균 사교육 비용
출처: 변수사전.csv(코드북 라벨) / 10_main.R
L08H104010
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: M2. 1=있음·2=없음. 사교육 비경험자 결측은 2(없음)로 채움. 판단권 최종 .080(p=.015).
차수별 변수: (1+2차) (수학) 과외/학원 경험 여부
출처: 변수사전.csv(코드북 라벨) / 10_main.R
L08H104019
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: M2. 1=있음·2=없음. 사교육 비경험자 결측은 2(없음)로 채움.
차수별 변수: (1+2차) (과학영역) 학습지/인터넷·통신과외 경험 여부
출처: 변수사전.csv(코드북 라벨) / 10_main.R
L08H102030
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: M2. 수업 중 질문(5점).
차수별 변수: (1+2차) 수업태도-질문
출처: 변수사전.csv(코드북 라벨) / 10_main.R
L08H102035
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: M2. 수업 중 타 과목 공부(5점).
차수별 변수: (1+2차) 학교수업시간에 대한 질문-타과목 공부
출처: 변수사전.csv(코드북 라벨) / 10_main.R
L08H102087
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: M2. 진로 및 직업 인식 셋 중 하나(5점).
차수별 변수: (1+2차) 진로교육/활동 만족도
출처: 변수사전.csv(코드북 라벨) / 10_main.R
L08H102125
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: M2. 리터러시 교차 확인 핵심 변수(최종 0.108, p<.001).
차수별 변수: (1+2차) 진로에 관한 질문-직업세계 변화흐름
출처: 변수사전.csv(코드북 라벨) / 10_main.R
L08H102126
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: M2. 진로 및 직업 인식 셋 중 하나(5점).
차수별 변수: (1+2차) 진로에 관한 질문-직업윤리
출처: 변수사전.csv(코드북 라벨) / 10_main.R
L08L102005
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: M2. 리터러시 최종 0.054(p<.001).
차수별 변수: (1+2차) 독서에 대한 질문-독서 선호
출처: 변수사전.csv(코드북 라벨) / 10_main.R
L08G101004
설문지 원문 미대조 — 아래는 코드북 라벨입니다.
분석 코딩: M2. M2 결단력(5점).
차수별 변수: (1+2차) 자신에 대한 질문-결단력
출처: 변수사전.csv(코드북 라벨) / 10_main.R
표 목록
| 표 | 제목 |
|---|---|
| 〈표 1〉 | 변수 구성 |
| 〈표 2〉 | 계층·교육 위치 축별 세 결과 지표의 분포 |
| 〈표 3〉 | 판단권 이양 전망의 위계 회귀 |
| 〈표 4〉 | 책임 있는 AI 리터러시의 위계 회귀와 최종 모형 계수 |
| 〈표 5〉 | 계층 축 표준편차 1 증가당 추정치(성별·수도권 거주 통제) |
| 〈그림 1〉 | 부모 학력에 따른 판단권 이양 전망과 책임 있는 AI 리터러시 |
사이트 주) 아래 〈표 1〉~〈표 5〉와 〈그림 1〉은 논문 정본의 마크업을 캡션과 주까지 그대로 옮긴 것입니다. 작업용 HTML 주석만 뺐습니다. 맨 아래 「보조 결과」는 심사 대응 보조 분석(S1~S24)의 CSV 값을 요약한 것입니다.
〈표 1〉 변수 구성
| 구분 | 문항·변수 | 척도·시점 / 투입 수 |
|---|---|---|
| 판단권 이양 전망 (주 종속변수) | 「AI로 인해 인간은 중요한 선택과 결정을 하지 않을 것이다」 | 6점, 7차(2023) N=7,742, 평균 3.78(SD 1.27), 동의 64.2%(5점 이상 31.2%) |
| 책임 있는 AI 리터러시 (보조 종속변수) | 「나는 AI 기술의 강점과 한계를 알고 있다」 / 「나는 AI 시대에 가져야 할 윤리적 의무를 알고 있다」 / 「나는 AI 기술을 사용하는 과정에서 지켜야 할 법적 책임을 알고 있다」 세 문항 평균 | 6점, 8차(2024) N=7,507, 평균 3.65(SD 1.17), α=.914 |
| AI 앱 사용 경험 (보조 종속변수) | 「귀하는 AI 앱(프로그램)을 활용해본 경험이 있습니까?」 | 이분, 8차(2024) N=7,521(기술통계)·7,507(회귀) 39.2%(2,951명) |
| M1 가정 배경 | 성별, 부모 최종 학력 중 높은 값, 아버지 월평균 소득, 수도권 거주, 도시 규모, 가정생활 만족도 | 6 |
| M2 고교 시기 | 고3 내신 평균, 중3 성적, 수학·과학 자신감, 고교 유형 더미 2, 사교육비, 수학 과외·학원, 수업 중 질문·타 과목 공부, 진로 및 직업 인식 3, 독서 선호, 결단력 등 | 16 |
| M3 대학·노동시장 | 대학 유형 더미 2(전문대·미진학), 계열(공학·자연·의약), 소재지(수도권), 7차 취업 여부. 8차 분석에는 8차 재직 여부와 업무 디지털 과업 수 추가 | 5 (8차 분석 7) |
| M4 AI 이용·기대·위험 | 7차 이용 빈도 4(번역·추천·얼굴 및 이미지 인식·음성인식), AI 긍정 기대 4, AI 위험 2(일자리 감소·개인정보 유출), 과학기술 일반 2(삶의 질 향상 기대·혜택 독점). 8차 분석에는 판단권 이양 전망·유대감 약화·대체불가 능력 추가 | 12 (8차 분석 15) |
주: 부모 최고 학력은 1~8(무학·초졸·중졸·고졸·전문대졸·대졸·석사·박사), 아버지 월 소득은 1~11의 소득 구간 서열 코드를 등간 점수로 투입했다. 민감도 분석에는 주 종속변수와 유대감 약화 문항의 평균을 함께 쓴다(N=7,743, r=.55). M3의 8차 재직 여부는 8차 업무 디지털 활용 문항 응답 여부로 조작화했다.
자료: 한국교육고용패널조사Ⅱ 1~8차
〈표 2〉 계층·교육 위치 축별 세 결과 지표의 분포
| 계층 축·범주 | 판단권 이양 전망(7차) | AI 리터러시(8차) | AI 앱 사용(8차) | |||||
|---|---|---|---|---|---|---|---|---|
| N | 동의율(%) | 평균 | N | 평균 | 상위 34.6%(%) | N | 사용률(%) | |
| 부모 학력 — 고졸 이하 | 3,231 | 66.1 | 3.84 | 3,137 | 3.49 | 29.1 | 3,143 | 34.3 |
| — 전문대 | 717 | 64.2 | 3.77 | 696 | 3.62 | 34.5 | 696 | 42.4 |
| — 4년제 이상 | 3,212 | 61.2 | 3.70 | 3,109 | 3.84 | 40.7 | 3,115 | 44.7 |
| 대학 유형 — 미진학 | 1,677 | 64.0 | 3.77 | 1,541 | 3.34 | 25.9 | 1,547 | 29.8 |
| — 전문대 | 1,744 | 69.4 | 3.90 | 1,684 | 3.44 | 27.8 | 1,689 | 31.1 |
| — 4년제 | 4,320 | 62.2 | 3.73 | 4,281 | 3.85 | 40.4 | 4,284 | 45.8 |
| [참고] 부모 학력 결측 | 582 | 70.8 | 3.93 | 565 | 3.54 | 31.5 | 567 | 33.0 |
주: 마지막 행을 뺀 각 축의 결측 범주는 표와 추세 검정에서 제외했고, 지표마다 응답 시점이 달라 열별 N이 다르다. 마지막 행은 부모 학력 결측 범주다. 기저 잔존율은 37.6%로 가장 낮고 앱 사용 33.0%도 부모 학력 축에서 가장 낮으나, 리터러시 3.54는 고졸 이하 3.49보다 높다. 비율의 추세 검정은 집락 미보정이다. 대학 유형은 열마다 정의가 다르다. 판단권 열은 2~7차, 나머지는 2~8차 기준이고, 유형·계열·소재지 일부만 결측인 1명은 어느 범주에도 넣지 않았다. 추세 p는 부모 학력 축이 다섯 지표 모두 <.001, 대학 유형 축이 동의율 .013·평균 .135·나머지 셋 <.001이다. 지면상 뺀 두 축도 같은 방향이다. 아버지 월 소득 축은 동의율 64.9→62.6%(p=.115)·리터러시 3.63→3.79·사용률 37.6→43.4%, 고교 유형 축은 동의율 66.2→58.5%·리터러시 3.47→3.88이다.
자료: 한국교육고용패널조사Ⅱ 1~8차
〈표 3〉 판단권 이양 전망의 위계 회귀
| 모형 | 투입 수 | R² | ΔR² |
|---|---|---|---|
| M1 가정 배경 | 6 | .0069 | .0069 |
| M2 + 고교 시기 | 22 | .0167 | .0097 |
| M3 + 대학·노동시장 | 27 | .0180 | .0013 |
| M4 + AI 이용·기대·위험 | 39 | .2587 (수정 .2549) | .2406 |
주: N=7,742, 416개교 집락 보정, 비가중. 표의 계수와 R²는 단일 대체본 추정치이고, 계층 변수의 추론 기준은 종속변수를 포함한 m=20 결합 추정치로 아래에 병기한다. M4에서 p<.05인 열둘은 본문에 적었고 유의하지 않은 27개는 생략했다. 부모 학력 계수 궤적(대체본): 이변량 −.050*** → M1 −.045** → M2 −.017 → M3 −.017 → M4 −.010; 완전사례 −.057*** → −.056*** → −.042* → −.043* → −.032*; 종속변수를 대체 모형에 넣은 다중대체(m=20) −.051*** → −.023 → −.023 → −.016이며, 본문의 계층 서술은 이 값을 기준으로 한다. 대체 방식별 비교는 4장 6) 참조. 7차 태도 11문항의 부모 학력 표준화 기울기는 005 .057, 006 .076, 007 .030, 008 −.016, 009 .007, 010 .052, 011 −.051, 012 −.006, 013 .056, 014 −.019, 015 .035로 모두 절댓값 .076 이하인 반면, 8차 인지 세 문항은 .137~.146이다. 선행연구가 쓴 009~012 합산 평균의 기울기는 −.003(p=.79)이고, 011을 009·010·014에 회귀한 잔차의 기울기는 −.063(p<.001)이다. 서열 로짓으로 보아도 표준편차 1당 OR .92(t=−3.87, 집락 보정 −3.43)여서 결론은 같다. 교차 확인 핵심 변수 열 개는 모두 생존율 100%이며 검증 표본 계수는 개인정보 유출 .292, 혜택 독점 .252, 일자리 감소 .216, 외로움 해소 기대 .204, 음성인식 .114, 효율적 업무 기대 −.103, 번역 −.096, 삶의 질 향상 기대 −.095, 추천 −.083, 얼굴·이미지 인식 .074다(N=3,865, 후보 383개 중 p<.05인 13개 가운데 BH 통과 10개). 태도 블록 가운데 348번의 과학기술 일반 두 문항만의 고유 몫은 .0405로 M4 증가분의 약 17%다.
자료: 한국교육고용패널조사Ⅱ 1~8차
〈표 4〉 책임 있는 AI 리터러시의 위계 회귀와 최종 모형 계수
| 모형·변수 | 투입 수 / 계수 | R² / SE | ΔR² / p | 교차 확인 (탐색적) |
|---|---|---|---|---|
| M1 가정 배경 | 6 | .0321 | .0321 | |
| M2 + 고교 시기 | 22 | .0939 | .0618 | |
| M3a + 대학(2~8차 최종) | 27 | .1046 | .0107 | |
| M3b + 8차 직무 | 29 | .1335 | .0289 | |
| M4 + AI 이용·기대·위험 | 44 | .1520 (수정 .1470) | .0185 | |
| 8차 재직 여부 (M3) | −0.463 | 0.050 | <.001 | |
| 대학 유형: 미진학 (M3) | −0.228 | 0.052 | <.001 | ✓ |
| 대학 유형: 전문대 (M3) | −0.184 | 0.041 | <.001 | ✓ |
| 업무 디지털 활용 과업 수 (M3) | 0.180 | 0.015 | <.001 | |
| 직업세계 변화 흐름 인식 (M2) | 0.108 | 0.017 | <.001 | ✓ |
| 대학 소재지: 수도권 (M3) | 0.098 | 0.036 | .008 | ✓ |
| 번역 서비스 이용 (M4) | 0.090 | 0.021 | <.001 | ✓ |
| 대학 계열: 공학·자연·의약 (M3) | 0.089 | 0.030 | .003 | ✓ |
| 부모 최고 학력 (M1) | 0.051 | 0.013 | <.001 | ✓ |
| 중3 성적(등급) (M2) | −0.041 | 0.011 | <.001 | ✓ |
주: N=7,507, 416개교 집락 보정, 비가중. 표의 계수와 R²는 단일 대체본 추정치이고, 계층 변수의 추론 기준은 종속변수를 포함한 m=20 결합 추정치로 아래에 병기한다. M3a·M3b 증가분의 합 .0396과 M3 합계 .0397의 차이는 반올림이고, 순서를 바꾸어도 직무의 몫이 크다. 8차 앱 사용을 함께 통제해도 부모 학력의 표준화 기울기는 .143에서 .115로 줄 뿐 유의하고 사용자·비사용자 양쪽에 남는다. 앱 미경험자 리터러시는 3.413, 경험자는 4.015다. 8차 재직 여부와 업무 디지털 활용 과업 수의 상관은 .765(검증 표본 .750)여서 자료 주도 절차의 상관 .7 규칙이 LASSO 계수 크기 순으로 과업 수를 사전 제거했고, 남은 재직 더미 단독은 검증 표본에서 유의하지 않아(b=.042, p=.320) 두 변수는 교차 확인 목록에 들지 못했다. 과업 수를 남기는 대안에서는 그 변수가 유의하므로(b=.084, p<.001) 이 목록은 필터의 우선순위에 민감하다. 표에는 p<.01인 계수 가운데 계층·교육 위치·직무 변수를 먼저 싣고 태도 변수는 절댓값 상위만 실었다. 생략한 것 가운데 독서 선호 0.054와 일자리 출현 기대 0.052가 p<.001이고 성별(여성 −0.083) 등 여섯이 p<.05였다. "교차 확인"은 검증 표본 유의·위계 최종 모형 유의·생존율 60% 이상 세 기준을 모두 충족한 아홉 변수이며 BH 보정은 요건이 아니다. 아홉 변수의 검증 표본 계수·BH q·생존율은 번역 이용 .105/.024/100%, 일자리 출현 기대 .077/.024/100%, 미진학 −.172/.161/100%, 직업세계 변화 흐름 인식 .072/.149/100%, 중3 성적 −.032/.175/100%, 수도권 대학 .106/.211/98%, 전문대 −.117/.211/96%, 공학·자연·의약 계열 .105/.161/94%, 부모 학력 .053/.124/70%다(검증 N=3,741, 후보 385개 중 p<.05인 14개 가운데 BH 통과 2개). 부모 학력 계수 궤적(종속변수 포함 다중대체 m=20): .136 → .067 → .055 → .054로 전 단계 p<.001이다. 대체 방식별 비교는 4장 6) 참조. 이론 블록 밖에서 생존율 60% 이상인 변수는 판단권 10개·리터러시 28개이고, 검증 p<.05인 일곱(생존율%, p, q)은 판단권 공부 이유 경쟁상대 이김(82, .015, .072)·희망 교육 수준(74, .044, .183)·학교 내외 수상(70, .029, .130), 리터러시 진로 정보 판별(98, .011, .149)·소유 IT 기기 기타(98, .026, .161)·진로 편견·고정관념(100, .026, .161)·독서 경험(74, .032, .175)이며 BH 통과는 0이다.
자료: 한국교육고용패널조사Ⅱ 1~8차
〈표 5〉 계층 축 표준편차 1 증가당 추정치(성별·수도권 거주 통제)
| 결과 지표 | 계층 축 | N | 추정치 [95% 신뢰구간] | p | Bonferroni |
|---|---|---|---|---|---|
| 전망 동의(≥4) | 부모 학력 | 7,157 | OR 0.907 [0.859, 0.957] | <.001 | 통과 |
| 아버지 소득 | 5,557 | OR 0.984 [0.927, 1.045] | .595 | 미통과 | |
| 전망 평균 | 부모 학력 | 7,157 | β −0.062 [−0.096, −0.029] | <.001 | 통과 |
| 아버지 소득 | 5,557 | β −0.004 [−0.044, 0.035] | .826 | 미통과 | |
| 리터러시 상위 34.6% | 부모 학력 | 6,940 | OR 1.280 [1.207, 1.356] | <.001 | 통과 |
| 아버지 소득 | 5,400 | OR 1.063 [0.999, 1.132] | .056 | 미통과 | |
| 리터러시 평균 | 부모 학력 | 6,940 | β 0.168 [0.135, 0.202] | <.001 | 통과 |
| 아버지 소득 | 5,400 | β 0.064 [0.026, 0.102] | .001 | 통과 | |
| AI 앱 사용 | 부모 학력 | 6,952 | OR 1.265 [1.196, 1.338] | <.001 | 통과 |
| 아버지 소득 | 5,408 | OR 1.107 [1.042, 1.176] | .001 | 통과 |
주: 결과 5개 × 계층 축 2개 = 10회 검정에 Bonferroni 보정(.005)을 적용했고 단순 모형에서도 통과 여부는 같았다. 부모 최고 학력은 1~8, 아버지 소득은 1~11의 서열 코드를 등간 척도로 투입했고, 표준화는 이 코드를 z로 바꾼 것이다. 본문의 부모 학력 기울기는 둘로 고정한다. 표의 β 0.168은 독립변수만 z화한 원척도 계수이고(N=6,940), 4장 4)의 .153은 두 변수를 z화해 두 지표에 공통인 6,728명으로 맞춘 값이다. 8차 소프트스킬 능력 자기평정을 함께 통제해도 부모 학력 기울기는 5분의 1가량 줄 뿐 유의하며, 위계 모형의 부모 학력·미진학·전문대 계수도 모두 유의하게 남는다. 일반 자기평정인 소프트스킬 15문항 평균과 부모 학력의 상관은 .082로 리터러시의 절반 수준이다. 잔존 확률의 역가중(S4 기반, 안정화·1~99분위 절단)으로 다시 추정해도 다섯 지표가 모두 유의하게 남으며, 기준값과의 대조는 5장 5)절에 있다.
자료: 한국교육고용패널조사Ⅱ 1~8차
그림 목록
〈그림 1〉 부모 학력에 따른 판단권 이양 전망과 책임 있는 AI 리터러시
- 파일:
R분석/결과/gradient/Fig1_gradient_contrast.png(생성 스크립트20_gradient.R(14)절) - 본문 위치: 4장 1) 기술통계와 계층별 분포
- 값: (a) 전망 동의율 66.1 · 64.2 · 61.2% / (b) 리터러시 평균 3.49 · 3.62 · 3.84
<그림 1> 부모 학력에 따른 판단권 이양 전망과 책임 있는 AI 리터러시
주: 오차 막대는 집락 미보정 95% 신뢰구간이다.
자료: 한국교육고용패널조사Ⅱ 1~8차
보조 결과 (S1~S24)
심사 대응 과정에서 돌린 보조 분석의 핵심 값입니다. 값은 모두 R분석/결과/supp/와 결과/gradient/의 CSV에서 읽었고, 파일명을 함께 적었습니다. 본문에 인용된 값은 본문 표기(반올림)를 따르며, 여기서는 CSV의 자릿수를 그대로 둡니다.
S1·S16 결측과 결측 집단 (S1_missing_rates.csv, S16_missing_profile.csv)
- 판단권 표본(N=7,742)에서 부모 최고 학력 결측은 582명(7.52%), 아버지 소득 결측은 2,183명(28.2%), 수도권 거주 결측은 488명(6.3%)입니다.
- 부모 학력 결측 582명은 특성화·마이스터고 45.9%, 미진학 35.3%, 아버지 소득 결측 96.0%로, 관측 집단(31.3%, 20.6%, 22.7%)보다 학업 위치가 낮습니다.
- 같은 집단의 전망 동의율은 70.8%, 리터러시 평균 3.558, 앱 사용 33.8%입니다.
S2·S3 결측 처리 방식별 계수와 부모 학력 궤적 (S2_impute_compare_rq1.csv, S3_paredu_trajectory.csv)
| 판단권(RQ1) 부모 학력 계수 | 단일 대체(m=1) | 완전사례 | 다중대체(m=20, 종속 제외) |
|---|---|---|---|
| M4 최종 계수 | −0.0097 (p=.4367) | −0.0315 (p=.0447) | −0.0161 (p=.2151) |
| 분석 N | 7,742 | 5,053 | 7,742 |
| 단계 | 판단권 단일 대체 | 판단권 완전사례 | 리터러시 단일 대체 | 리터러시 완전사례 |
|---|---|---|---|---|
| 이변량 | −0.0495 | −0.0565 | 0.1528 | 0.1539 |
| M1 | −0.0451 | −0.0559 | 0.1336 | 0.1391 |
| M1+M2 | −0.0173 (p=.2218) | −0.0416 (p=.0158) | 0.0640 | 0.0716 |
| M1+M2+M3 | −0.0174 | −0.0425 | 0.0529 | 0.0554 |
| M1~M4 | −0.0097 | −0.0315 (p=.0447) | 0.0512 | 0.0485 |
S4 패널 탈락 (S4_attrition.csv)
- 7차 잔존율은 부모 학력 고졸 이하 77.8%, 전문대 81.4%, 4년제 이상 80.7%이고 결측 집단은 37.6%입니다.
- 중3 성적 최하위 4분위 64.5%, 특성화·마이스터고 69.4%, 여성 70.8%, 거주지 결측 34.6%로 낮습니다.
- 잔존 로지스틱(동시 투입)에서 부모 학력 결측 OR .671(p=.0381), 중3 성적 4분위(하위) OR .537, 여성 OR .709입니다.
S5 두 기울기 차이 (S5_slope_diff.csv)
| 항목 | 추정치 | 부트스트랩 95% CI | ||||
|---|---|---|---|---|---|---|
| 판단권 이양 전망(z) ~ 부모 학력(z) | −0.0494 | [−0.0762, −0.0239] | ||||
| 리터러시(z) ~ 부모 학력(z) | 0.1532 | [0.1239, 0.1830] | ||||
| 절댓값 차이 \ | β₂\ | − \ | β₁\ | 0.1038 | [0.0654, 0.1397] |
N=6,728, 416개교, 학교 단위 부트스트랩 400회입니다. 본문은 이를 .104 [.065, .140]으로 적습니다.
S6 전망×리터러시 4유형의 정보량 (S6_typology_expected.csv)
- 전망 동의(4점 이상)이면서 리터러시가 중위수 미만인 셀은 27.5%이고, 독립 가정의 기대치는 26.5%입니다(φ=.0409).
- 전망 기준을 5점 이상으로 올리면 φ=−.0053(p=.6543)으로 연관이 사라집니다.
S7·S8 이용 빈도와 앱 경험 (S7_use_crosstab.csv, S8_use_bivariate.csv)
- 7차에 번역을 "자주" 쓴다는 1,780명 가운데 47.9%가 8차에 앱 경험이 없다고 답했습니다.
- 전망 1~6점의 8차 앱 경험률은 43.2, 47.3, 41.9, 37.4, 38.2, 35.1%로 단조롭지 않습니다.
- 전망과 이용 문항의 이변량 상관은 번역 −.0158, 추천 −.0099, 얼굴·이미지 인식 .1231, 음성인식 .1422입니다.
S9·S12b 재직·디지털 과업과 리터러시 (S9_emp_tasks.csv, S12b_emp_by_univ.csv)
| 집단 | N | 리터러시 평균 | 앱 경험률 |
|---|---|---|---|
| 비재직 | 3,252 | 3.727 | 40.6% |
| 재직·과업 0 | 342 | 2.908 | 16.6% |
| 재직·과업 1~2 | 1,707 | 3.446 | 28.7% |
| 재직·과업 3+ | 2,206 | 3.810 | 48.9% |
8차 재직률은 미진학 75.5%, 전문대 70.2%, 4년제 44.6%입니다. 4년제 안에서는 비재직 3.850, 재직 3.840으로 같습니다.
S10·S21 판단권 문항과 이웃 문항의 상관 (S10_rq1_corr.csv, S21_rq1_item_corr.csv)
- 유대감 약화 .5497, 혜택 독점 .3321, 개인정보 유출 .3200, 일자리 감소 .2944, 외로움 해소 기대 .2208입니다.
- 삶의 질 향상 .0111, 인간의 대체불가 능력 .0059로 무관합니다.
- 347번 네 문항 α는 .712, 판단권 문항을 뺀 세 문항 α는 .6377, 판단권 문항과 나머지 세 문항 평균의 상관은 .5213입니다.
S11·R3 수도권 거주와 앱 사용 (S11_capital_by_univ_chisq.csv, R3_capital_or_steps.csv)
| 집단 | 비수도권 사용률 | 수도권 사용률 | p |
|---|---|---|---|
| 전체 | 43.5% | 34.7% | <.001 |
| 미진학 | 35.5% | 18.6% | <.001 |
| 전문대 | 39.3% | 22.3% | <.001 |
| 4년제 | 48.3% | 43.9% | .005 |
위계 단계별 수도권 거주 OR은 M1 .6433, M2 .6011, M3 .5599, M4 .5579입니다. 원인은 확인되지 않았고 원고는 한계로 남깁니다.
S12 리터러시 M3 분리 (S12_m3_split.csv)
- 대학(M3a)을 먼저 넣으면 ΔR² .0107, 이어서 8차 직무(M3b) .0289입니다.
- 순서를 바꾸면 직무 .0305, 대학 .0092로, 어느 순서든 직무의 몫이 큽니다.
S13 7차 전망과 8차 리터러시 (S13_rq3_bivariate.csv)
- 이변량 상관 r=−.0454(N=7,247)입니다.
- 회귀계수는 통제 없음 −.0366(p=.0073), M1~M3 통제 −.0179(p=.1519), M1~M4 통제 −.0198(p=.148)입니다.
S14 앱 사용과 리터러시 (S14_lit_by_use.csv)
- 앱 경험 없음 3.413, 경험 있음 4.015입니다.
- 부모 학력 표준화 기울기는 성별·수도권 통제 .1431, 앱 사용을 더 통제하면 .1153입니다. 비사용자 내부 .0963, 사용자 내부 .1493으로 양쪽에 남습니다.
S15 이론 블록 밖 안정 변수 (S15_offblock_stable.csv)
- 블록 밖에서 생존율 60% 이상인 변수는 판단권 10개, 리터러시 28개입니다.
- 이 가운데 검증 p<.05인 일곱의 BH 통과는 0개입니다.
S17 5점 이상 동의 (S17_agree5.csv)
전체 31.2%이고, 부모 학력별 31.8, 32.1, 29.9%로 평평합니다.
S18 종속변수를 포함한 다중대체 m=20 (S18_mi_with_dv.csv)
| 단계 | 판단권 부모 학력 계수 (p) | 리터러시 부모 학력 계수 (p) |
|---|---|---|
| M1 | −0.0505 (.0009) | 0.1361 (<.001) |
| M2 | −0.0227 (.1182) | 0.0669 (<.001) |
| M3 | −0.0231 (.1146) | 0.0551 (<.001) |
| M4 | −0.0161 (.2181) | 0.0537 (<.001) |
판단권 M4 계수는 종속변수를 뺀 m=20의 −0.0161(p=.2151)과 같습니다. 본문의 계층 서술은 이 결합 추정치를 기준으로 합니다.
S19 판단권 M4 분리 (S19_m4_split.csv)
- 이용 빈도를 먼저 넣으면 ΔR² .0263, 이어서 태도 .2144입니다.
- 순서를 바꾸면 태도 .2277, 이용 빈도 .0130입니다.
- 태도 블록 안에서 과학기술 일반 두 문항(013·014)만의 고유 몫은 .0405입니다.
S20 소프트스킬 능력 통제 (S20_softskill_control.csv)
- 성별·수도권 통제 사양의 부모 학력 기울기는 0.1663에서 소프트스킬 능력 자기평정을 더 통제하면 0.1369로 줄고 유의하게 남습니다.
- 앱 경험자 안에서 활용 역량 5문항 α .865, 책임 인지 3문항 α .879, 두 하위척도 상관 .57입니다.
S22 잔존 역확률 가중 (S22_ipw_gradient.csv)
| 결과 | 비가중 | IPW |
|---|---|---|
| 전망 동의 OR | 0.9074 | 0.9071 |
| 전망 평균 β | −0.0620 | −0.0626 |
| 리터러시 상위 OR | 1.2768 | 1.2832 |
| 리터러시 평균 β | 0.1666 | 0.1701 |
| 앱 사용 OR | 1.2617 | 1.2638 |
S23 문항별 계층 기울기 (S23_item_gradients.csv)
- 7차 태도 11문항의 부모 학력 표준화 기울기는 모두 절댓값 .0759 이하입니다. 판단권 문항은 −.0509입니다.
- 8차 인지 세 문항은 .1463, .1379, .1366입니다.
- 009~012 합산 평균은 −.0034(p=.7883), 판단권 문항을 009·010·014에 회귀한 잔차는 −.0632(p<.001)입니다.
- 서열 로짓 OR은 .9215(집락 미보정 t=−3.872, 집락 보정 t=−3.43)입니다.
- 앱 경험자 안에서 「AI가 어떤 절차를 거쳐 답을 제공하는지 설명할 수 있다」의 기울기는 .1354입니다.
- 잔차의 블록 통제 궤적은 대체본 M1+M2+M3 −.0151(p=.2495), 완전사례 −.0336(p=.0383)입니다.
S24 상관 .7 필터의 부산물 (S24_filter_byproduct.csv)
- 리터러시의 LASSO 선택 변수 가운데 상관 .7 초과로 빠진 쌍은 다섯입니다.
- 8차 재직 여부와 업무 디지털 과업 수의 상관은 원자료 .7645, 검증 표본 .7495입니다.
- 실제 사양에서 남은 재직 더미 단독은 b=.0424(p=.3195)입니다. 과업 수를 남기는 대안에서는 b=.0835(p<.001)입니다.
참고문헌 49건
논문 정본의 표기를 그대로 옮겼습니다. 국문 학술지는 「」, 도서·보고서는 『』, 영문 학술지명은 이탤릭이 원문 서식입니다.
국문 문헌
- 고보경·김유민·정재현·이채린·곽헌동 (2026). AI 디지털교과서(AIDT) 도입의 방해요인과 해결방안: 현장 교사의 인식과 윤리적 쟁점을 중심으로. 「교육공학연구」, 42(2), 545-581.
- 권동진·권창미 (2025). 대학 수업에서 인공지능 리터러시와 디지털 리터러시의 차별적 효과 분석: 역량 인식 변화를 중심으로. 「사고개발」, 21(3), 195-210.
- 김설인·구혜경 (2021). 청년은 정보 활용격차에서 자유로운가?: 한국 2030 청년세대의 모바일 정보 활용에 관한 연구. 「한국콘텐츠학회논문지」, 21(1), 39-54.
- 김소희·이기혜 (2022). AI로 인한 미래 사회변화에 대한 대학생의 인식에 영향을 미치는 요인 탐색: 대학유형별 비교를 중심으로. 「한국교육학연구」, 28(4), 23-46.
- 김영기 (2022). 대학생의 미래 인공지능(AI) 기술에 대한 긍정 및 부정정서와 미래 인생 태도에 영향을 미치는 요인. 「한국지식정보기술학회 논문지」, 17(5), 959-969.
- 김준서 (2026). 인공지능기본법상 교육 분야 고영향 인공지능에 관한 법적 쟁점. 「교육법학연구」, 38(2), 83-104.
- 노환호·김현정·김민진 (2024). 한국형 생성 인공지능 리터러시 척도 개발 및 타당화. 「지식경영연구」, 25(3), 145-171.
- 박노형·김효권 (2022). 자동화된 결정에 관한 개인정보보호법 정부 개정안 신설 규정의 문제점: EU GDPR과의 비교 분석. 「사법」, 62, 361-390.
- 박보람·노성호 (2026). 대학생의 인공지능 기반 의사결정 수용도 분석: 사회인지영역이론에 따른 영역별 판단 비교. 「교육연구」, 95, 287-308.
- 박성준·나종민 (2025). 계획된 행동이론으로 바라본 청년층의 인공지능 수용에 대한 자기효능감과 우울감의 조절된 매개효과. 『2025 KRIVET 패널 학술대회 자료집』 77-100.
- 여소담·한창근 (2024). 청년의 디지털 리터러시 수준이 디지털 관련 일상만족도에 미치는 영향: 디지털 기술 효능감의 매개효과 검증. 「사회복지연구」, 55(2), 111-132.
- 오주현 (2026). AI 포용 관점에서 본 생성형 인공지능(AI) 이용 격차: 인지, 이용, 활용. 「KISDI STAT Report」, 26-04, 1-8.
- 우창빈 (2025). 인공지능(AI) 시대 정부의 도전과제의 대응 및 공무원의 필요역량: 인간중심 다층-메타 AI 거버넌스. 「Crisisonomy」, 21(12), 61-86.
- 이슬기 (2025). AI의 편리함은 누구에게 역설이 되는가?: 생성형 AI 이용 레퍼토리와 정보격차 요인에 따른 신뢰, 편의, 의존 인식 차이. 「사이버커뮤니케이션학보」, 42(4), 145-194.
- 이준혁·김채원·김현정 (2025). 자동화된 의사결정 시스템의 공정성과 편향성이 수용성에 미치는 영향. 「경영정보학연구」, 27(1), 155-177.
- 임다미·이영 (2025). 대학 졸업자의 AI 준비도, 업무 디지털 활용 수준, 소프트스킬 보유도에 따른 잠재집단분류 및 일자리 만족도, 행복도와의 관계 분석. 『2025 KRIVET 패널 학술대회 자료집』 181-198.
- 정란 (2025). 자동화된 의사결정 규제에 관한 비교법적 고찰 및 한국 법제에의 시사점. 「미디어와 인격권」, 11(3), 43-102.
- 정애령 (2026). 인공지능의 자동화된 의사결정에 대한 인간의 개입. 「유럽헌법연구」, 50, 161-187.
- 정지영·김난옥 (2025). 대졸 취업자의 디지털 활용 수준과 직무만족도 관계에서 AI 활용 준비도의 매개효과. 『2025 KRIVET 패널 학술대회 자료집』 199-218.
- 주연경 (2023). 알고리즘 혐오와 자율주행차 사고에 대한 대중의 인식: 통제가능성, 불안도, 사고에 대한 책임을 중심으로. 「차세대융합기술학회논문지」, 7(8), 1346-1357. (본문 인용 쪽수는 판본에 관한 각주 참조)
- 황지은 (2020). 인공지능 관점에서 GDPR 제22조의 인간 개입에 대한 분석. 「경제규제와 법」, 13(1), 37-58.
법령·정부 자료·통계
- 개인정보 보호법 [시행 2024. 3. 15.] [법률 제19234호, 2023. 3. 14., 일부개정].
- 개인정보 보호법 시행령, 제44조의2부터 제44조의4까지.
- 과학기술정보통신부 관계부처 합동 (2023). 『디지털 공동번영사회의 가치와 원칙에 관한 헌장』(디지털 권리장전).
- 과학기술정보통신부·한국지능정보사회진흥원 (2025). 『2024년 디지털정보격차 실태조사』.
- 과학기술정보통신부·한국지능정보사회진흥원 (2026). 『2025년 인터넷이용실태조사』.
- 교육기본법, 제9조.
- 교육부 (2022). 『교육분야 인공지능 윤리원칙』(2022. 8. 11. 발표).
- 교육부 (2025). 「학교의 안전하고 효과적인 학습지원 소프트웨어 선정을 위한 기준 안내」(보도자료, 2025. 12. 30.) 및 [별첨] 『학습지원 소프트웨어 선정기준 및 가이드라인』. 세종: 교육부.
- 교육부 (2026). 「인공지능 중점학교 1,141개교 선정」(보도자료, 2026. 3. 9.).
- 국가데이터처·교육부 (2026). 『2025년 초·중·고 사교육비조사 결과』.
- 국가인공지능전략위원회·과학기술정보통신부 (2026). 『대한민국 인공지능 행동계획: 인공지능 기본계획(2026~2028)』.
- 인공지능 발전과 신뢰 기반 조성 등에 관한 기본법 [시행 2026. 7. 21.] [법률 제21311호, 2026. 1. 20., 일부개정].
- 인공지능 발전과 신뢰 기반 조성 등에 관한 기본법 시행령 [시행 2026. 8. 20.] [대통령령 제36580호, 2026. 8. 18., 타법개정].
- 초·중등교육법, 제29조의2(2025. 8. 14. 개정, 2026. 3. 1. 시행).
- 한국직업능력연구원 (2025). 『한국교육고용패널조사Ⅱ(KEEP II) 1~8차 원자료』.
영문 문헌·국외 법령
- Araujo, T., Helberger, N., Kruikemeier, S., & de Vreese, C. H. (2020). In AI we trust? Perceptions about automated decision-making by artificial intelligence. AI & Society, 35, 611-623.
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B, 57(1), 289-300.
- Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Algorithm aversion: People erroneously avoid algorithms after seeing them err. Journal of Experimental Psychology: General, 144(1), 114-126.
- Hargittai, E. (2002). Second-level digital divide: Differences in people's online skills. First Monday, 7(4).
- Logg, J. M., Minson, J. A., & Moore, D. A. (2019). Algorithm appreciation: People prefer algorithmic to human judgment. Organizational Behavior and Human Decision Processes, 151, 90-103.
- Long, D., & Magerko, B. (2020). What is AI literacy? Competencies and design considerations. Proceedings of the 2020 CHI Conference on Human Factors in Computing Systems, Paper 598, 1-16.
- Meinshausen, N., & Bühlmann, P. (2010). Stability selection. Journal of the Royal Statistical Society: Series B, 72(4), 417-473.
- Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B, 58(1), 267-288.
- van Buuren, S., & Groothuis-Oudshoorn, K. (2011). mice: Multivariate imputation by chained equations in R. Journal of Statistical Software, 45(3), 1-67.
- van Deursen, A. J. A. M., & van Dijk, J. A. G. M. (2014). The digital divide shifts to differences in usage. New Media & Society, 16(3), 507-526.
- van Dijk, J. A. G. M. (2005). The deepening divide: Inequality in the information society. Sage.
- Regulation (EU) 2016/679 (General Data Protection Regulation), Article 22.
- Regulation (EU) 2024/1689 (Artificial Intelligence Act), Articles 4, 14.