발표 슬라이드 9장입니다. 화살표나 아래 점을 누르면 넘어가고, 슬라이드마다 자료·코딩, 분석 상세, 예상 질문과 답, 용어가 아래에 함께 열립니다. 슬라이드를 누르면 크게 볼 수 있습니다.
더 보기
1. 논문·저자·수상
| 항목 | 내용 |
|---|---|
| 제목 | 어떤 고등학교 특성이 청년기 임금 격차로 이어지는가 |
| 부제 | ― 한국교육고용패널Ⅱ(KEEP II)를 활용한 LASSO와 위계적 회귀의 교차검증 ― |
| 저자 | 이현진 (숭실대학교 일반대학원 교육경영학과 박사수료) |
| 이메일 | 2117math@gmail.com |
| 수상 | 2026 KRIVET 학술대회 대학원생 논문 경진대회 우수상 |
| 발표 | 2026년 10월 1일(목), 여의도 FKI타워 |
| 자료 | 한국교육고용패널Ⅱ(KEEP II) 1~9차 (한국직업능력연구원) |
| 주제어 | 임금 격차, 사교육, 고등학교 특성, LASSO, 한국교육고용패널 |
| Keywords | wage gap, private tutoring, high-school characteristics, LASSO, KEEP II |
한 줄 요약: 고교 시기 수백 개 특성 가운데 데이터 주도(LASSO)·이론 주도(위계적 회귀)·50회 다중분할의 세 관문을 모두 통과한 신호는 다섯이며, 그 신호에 대한 접근 자체가 부모 학력·소득에 따라 계층화되어 있었습니다.
2. 연구문제 3개 (논문 Ⅰ장 원문)
- 연구문제 1. 고등학교 시기의 특성은 청년기(9차, 약 26세) 임금을 어느 정도 설명하는가?
- 연구문제 2. 데이터 주도(LASSO)와 이론 주도(위계적 회귀)에서 공통적으로, 그리고 다중분할에서 안정적으로 선택되는 임금 결정요인은 무엇이며, 그 요인에 대한 접근은 가정 배경에 따라 어떻게 분화되는가?
- 연구문제 3. 성취·투자, 제도, 학생 참여, 가족 배경(SES)·지역의 네 영역이 청년기 임금 격차에 더하는 증분 기여는 영역별로 어떠하며, 임금에 남는 요인은 어떤 해석틀로 묶이는가?
연구문제별 답(논문 Ⅴ.1 요약)
- RQ1: 설명력은 낮습니다(검증표본 R²≈.085, 50회 분포 중앙값 .080). 진입기 요인에 더해 측정 희석·임금 압축이 함께 작용한 결과로, 초기 임금을 고교 특성만으로 설명하기는 어렵습니다.
- RQ2: 삼중 관문 통과 요인은 다섯(과학 사교육 2종·고교 계열·수도권 거주·조건부 중3 성적). 검증 통과 과학 사교육의 접근은 부모 학력·소득에 따라 계층화되어 있었습니다.
- RQ3: 네 영역 모두 블록 결합 검정에서 유의하나 최대 증분 기여 영역은 판별되지 않습니다(판별 유보). 임금에 남는 신호의 해석틀은 '접근이 계층화된 사교육 자본'과 '형성에 기울기가 있는 능력·구조 신호'의 두 갈래입니다.
3. 핵심 수치표
| 구분 | 값 | 출처 |
|---|---|---|
| 주 분석 표본 N | 2,022명 (9차 전일제 임금근로자) | 논문 Ⅲ.1 |
| 모집단 경로 | 일반계고 코호트 5,393명 → 9차 응답 3,978명(마모 약 26%) → 전일제 2,022명(50.8%) = 코호트의 37.5% | 논문 Ⅲ.1, [그림 1] |
| 집락(학교) | 216개교, 평균 9.4명, 로그 월임금 학교 내 상관 ICC=.042 | 논문 Ⅲ.2 다 |
| 검증표본 | 108개교, N=1,003 (학교 단위 50:50 분할) | 논문 Ⅳ.2 |
| A안 후보 변수 | 314개 → LASSO 선택 24개 → 다중공선성 정제 후 23개 | 논문 Ⅳ.2 |
| A안 검증표본 R² | .085 (RMSE .234), 무누수 재계산 .087, 훈련 CV R² .081 | 논문 Ⅳ.2, Ⅲ.3 가 |
| 50회 다중분할 검증 R² 분포 | 중앙값 .080, 사분위 [.070, .086] | 논문 Ⅳ.2 |
| A안 명목 유의(p<.05) 변수 | 16개 | 논문 Ⅳ.2, 〈표 2〉 |
| B안 투입 변수 | 89개 이론변수(M1 17 → M2 44 → M3 71 → M4 89) | 논문 Ⅲ.2 나, 〈표 3〉 |
| B안 M4 설명력 | R²=.146 (수정 R² .107) | 〈표 3〉 |
| 영역별 ΔR² | M1 .064 / M2 .019 / M3 .035 / M4 .028 | 〈표 3〉, [그림 2] |
| 재태깅 ΔR²(양육 4문항 가족 귀속) | M3′ 순수 참여 .030 / M4′ 확장 가족 배경 .034 | 〈표 3〉 |
| 블록 결합 Wald | 순수 참여 F=1.63(p=.046) / 확장 가족 배경 F=3.87(p<.001) | 논문 Ⅳ.3 |
| RQ3 판별 유보 근거 | 양육 제외 위계(85변수)에서 M3·M4 각 Δ.028 동률, 학교 부트스트랩 500회 M4−M3 증분차 95% CI [−.013, .030] | 논문 Ⅳ.3 |
| 다중분할 안정 변수(생존율 ≥60%) | 18개 | 〈표 4〉 |
| 삼중 관문 통과 요인 | 5개 (+ 참고 1개) | 〈표 5〉 |
| 성별 계수 | β=−.036, p=.0016 (여성 임금↓) — 유일하게 Bonferroni(.0022) 통과 | 〈표 2〉 |
| 월임금 평균 | 283.9만원(SD 76.1), 로그 월임금 5.62(SD 0.24) | 〈표 1〉 |
SES 기울기(표준화 SES +1SD당 승산비 OR) — 〈표 7〉
| 대상 | SES 지표 | 분석표본 | 전체 코호트 |
|---|---|---|---|
| 과학 학습지·통신과외 | 부모 학력 | 1.26 (p=.006) | 1.30 (p<.001) |
| 과학 과외·학원 | 부모 학력 | 1.31 (p=.001) | 1.41 (p<.001) |
| 과학 과외·학원 | 부 월소득 | 1.39 (p<.001) | 1.53 (p<.001) |
| 중3 상위 성적 | 부모 학력 | 1.42 (p<.001) | 1.33 (p<.001) |
| 수도권 거주 | 부모 학력 | 1.16 (p=.014, 보정 .0125 미통과) | 1.20 (p<.001) |
| 이과 계열 | 부모 학력 | 1.03 (n.s.) | 1.03 (n.s.) |
| 넓게 정의한 과학 사교육(방과후 포함, broad) | 부모 학력 | OR 1.08 (미약) | — |
해석 요지: 계층화된 것은 '과학 사교육 일반'이 아니라 검증을 통과한 특정 형태입니다. 임금에 대한 SES×사교육 상호작용은 비유의(가장 작은 값도 p=.08)여서, 관측된 계층성은 임금 '수익률'이 아니라 '접근'의 차이를 시사합니다.
4. 삼중 관문 통과 5요인 (〈표 5〉)
| 요인 (변수코드) | 척도 | β (A안 / B안 M4) | 생존율 | 방향 해석 |
|---|---|---|---|---|
| [과학] 과외·학원 경험 (L08H104018) | 유/무 | −.046* / −.045* | 94% | 경험자 임금↑ |
| 고교 계열(문과/이과) (L08H101009) | 1문~4직 | +.028* / +.034** | 92% | 자연계일수록 임금↑ |
| 중3 성적등급 (L08H102153) | 9등급 | −.009* / −.011* | 86% | 성적 우수할수록 임금↑ (조건부) |
| 수도권 거주 (is_Capital) | 더미 | +.030** / +.033** | 76% | 수도권 거주 임금↑ |
| [과학] 학습지·통신과외 (L08H104019) | 유/무 | −.039* / −.054** | 70% | 경험자 임금↑ |
| 〔참고〕 고3 영어 내신등급 (L08H102067) | 9등급 | −.010* / −.012 (p=.060) | 86% | 성적 우수할수록 임금↑ |
- 코딩 방향: 사교육·흡연 1=있음·2=없음이므로 β<0 = 경험할수록 임금↑. 내신·중3 성적은 1=최상~9=최하이므로 β<0 = 성적 우수. 계열 β>0 = 이과. 성별 1=남·2=여이므로 β<0 = 여성 임금↓.
- 계열 재코딩 확인: 이과 더미(기준 문과)로 바꿔도 유의(단순모형 β=.072, M4 β=.059, p<.001) → 실체는 '이과 > 문과'.
- 중3 성적이 '조건부'인 이유: 가중 사양 p=.116, 시간당 임금 사양 p=.052로 흔들립니다. 따라서 '네 요인 + 조건부 한 요인'이 정확한 표현입니다.
- 과학 사교육의 크기: 능력·구조 지표를 통제한 M4에서도 남아, 경험자 임금이 약 4~5% 높게 남는 신호였습니다.
- 왜 과학만인가: 국어(p=.120)·영어(p=.633)·수학(p=.165) 사교육은 임금에 남지 않았습니다. 과학이 STEM 전공·직종 배치의 대리 지표이거나, 상위 계층 자원이 변별력 높은 과학에 선택적으로 정렬된 결과일 수 있습니다(경합 설명이며 본 설계로 확정 불가).
5. 발표에서 지켜야 할 서술 규율
- 확증형 표현을 쓰지 않습니다: "입증", "완벽히", "증명" 금지. 논문 톤은 탐색적 신호, 판단 보류, 경합 설명입니다.
- 확립된 발견(자료로 뒷받침되는 것) = ① 검증 통과 사교육의 부모 SES 접근 기울기 ② 성별 임금 격차.
- 탐색적 신호 = 삼중 관문 5요인과 '자본·능력 이원 구조'라는 라벨 자체(후선택·단일 시점의 성격).
- '이원 구조'는 사전 이론 범주가 아니라 결과 패턴을 요약한 서술적 라벨입니다.
- 본 연구는 9차 단일 시점 설계입니다. 차수 간 비교(8차 대비 변화)는 본 논문의 주장이 아닙니다.
더 보기
열두 절입니다. 제목을 누르면 펼쳐집니다. 각 절은 쉬운 설명, 정의와 수식, 이 논문에서, 출처 순입니다.
1. LASSO — 계수를 0으로 만드는 벌점회귀
쉬운 설명
변수가 수백 개면 회귀분석은 잡음까지 외워버립니다. LASSO는 "계수를 크게 쓰려면 벌금을 내라"는 규칙을 회귀식에 붙인 방법입니다. 예산이 정해진 장보기처럼, 값어치가 있는 변수에만 예산을 쓰고 나머지 계수는 정확히 0으로 떨어뜨립니다. 그래서 추정과 변수 선택을 한 번에 합니다. 연구자가 "이 변수가 중요할 것 같다"고 먼저 고르지 않아도 되므로, 사전 지정의 자의성을 줄입니다.
정의와 수식
β̂ = argmin { Σᵢ (yᵢ − xᵢᵀβ)² + λ Σⱼ |βⱼ| }- 앞항 Σ(yᵢ − xᵢᵀβ)² = 보통의 최소제곱 오차.
- 뒷항 λ Σ|βⱼ| = 계수 절댓값 합에 매기는 L1 벌점. 절댓값이라 계수가 0에 정확히 닿습니다(제곱합 L2/릿지는 0으로 만들지 못합니다).
- λ = 벌금의 세기. 크면 적게 남기고, 작으면 많이 남깁니다.
이 논문에서
종속변수가 연속형(로그 월임금)이므로 family="gaussian", alpha=1(순수 LASSO)로 적합했습니다. 후보 314개(결측 30% 미만·분산 0 초과인 고교 수치형 변수 전체) 가운데 λ.min에서 24개가 비영 계수로 선택되었습니다.
출처: Tibshirani (1996); 구현은 Friedman, Hastie, & Tibshirani (2010)의 glmnet.
2. 10겹 교차검증과 λ.min vs λ.1se
쉬운 설명
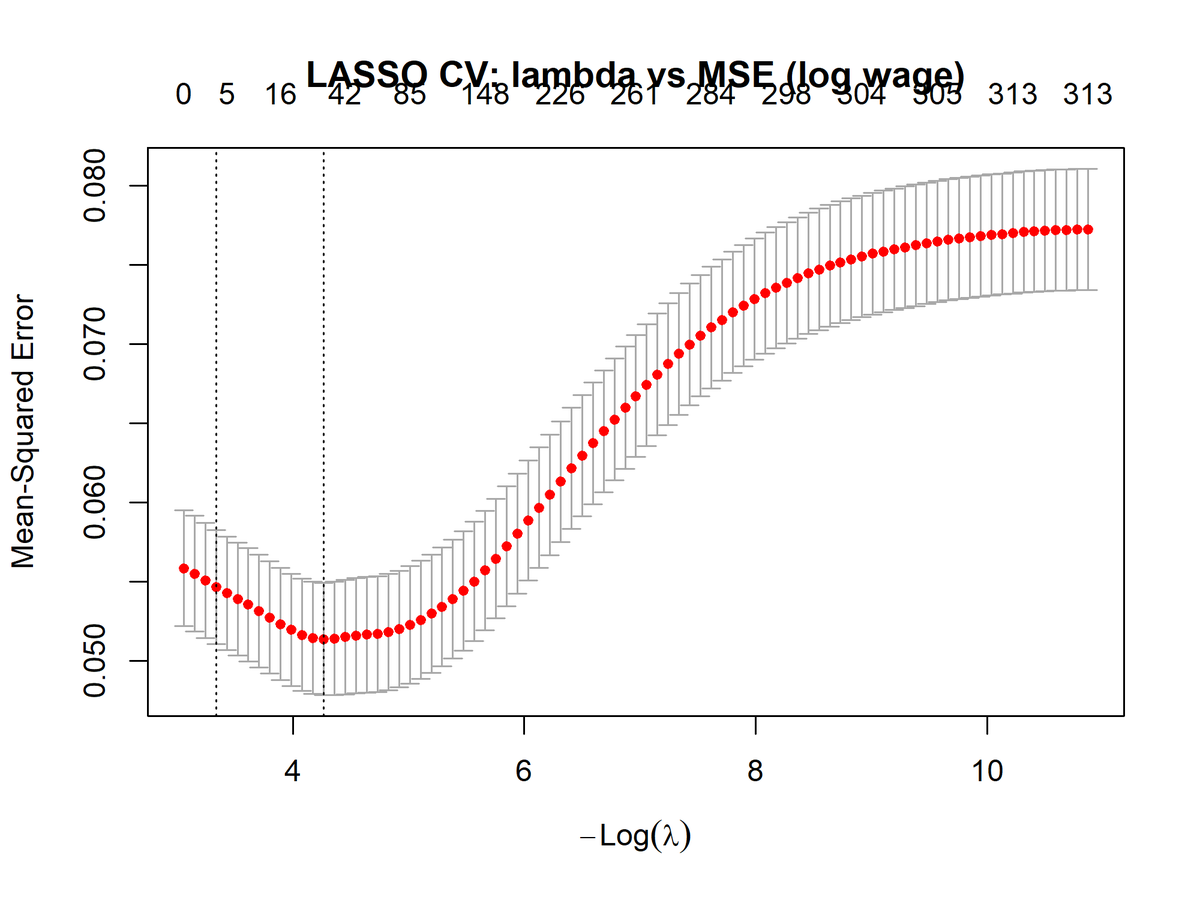
벌금의 세기 λ를 사람이 고르면 또 자의성이 들어옵니다. 그래서 훈련자료를 10등분해, 9조각으로 배우고 남은 1조각으로 맞혀보기를 열 번 돌립니다. 열 번의 오차를 평균해 가장 낮은 지점의 λ를 씁니다. 힌트가 모자라면 못 맞히고 넘치면 헷갈리므로, 오차 곡선은 U자를 그립니다.
정의와 수식
CV(λ) = (1/K) Σₖ MSEₖ(λ),  K = 10
λ.min = argmin CV(λ)
λ.1se = max { λ : CV(λ) ≤ CV(λ.min) + SE(λ.min) }- λ.min = 오차가 가장 낮은 바닥.
- λ.1se = 바닥에서 표준오차 하나만큼 위로 올라간, 더 인색한(변수를 더 적게 남기는) 기준.
이 논문에서
주 분석은 nfolds=10의 λ.min을 썼습니다(선택 24개, 검증 R² .085). 강건성 점검으로 λ.1se를 적용하면 선택이 8개로 줄고 검증 R²는 .040으로 낮아집니다(〈표 6〉). 즉 결론은 λ 선택 기준에 어느 정도 의존하며, 논문은 이를 감추지 않고 공개합니다.
출처: Friedman, Hastie, & Tibshirani (2010).
3. 예측변수 표준화와 가우시안 family
쉬운 설명
LASSO의 벌금은 계수 크기에 매겨지는데, 변수 단위가 제각각이면(등급 1~9, 만원, 0/1 더미) 단위가 큰 변수가 부당하게 유리하거나 불리해집니다. 그래서 모든 예측변수를 평균 0·표준편차 1로 맞춘 뒤 벌금을 매깁니다. 또 결과변수가 연속형인지 이분형인지에 따라 모형의 계열(family)이 달라지는데, 임금은 연속형이므로 가우시안(선형)을 씁니다.
정의와 수식
zⱼ = (xⱼ − x̄ⱼ) / sⱼ        (표준화)
y = 로그 월임금,  y | x ~ Normal(xᵀβ, σ²)   (가우시안 family)
로그 변환:  y = ln(월임금),  계수 β ≈ 해당 변수 1단위당 임금의 % 변화
이 논문에서
standardize=TRUE로 적합했습니다. 종속변수는 월임금을 로그 변환한 값입니다(50만원 미만·1,500만원 초과 제외 후 1·99 분위 윈저화, 그다음 자연로그). 계수는 로그 임금 기준이므로 −.046은 대략 4~5%의 임금 차이로 읽습니다.
출처: Tibshirani (1996); Friedman, Hastie, & Tibshirani (2010).
4. 다중공선성 정제 (|r| > 0.7, VIF > 5)
쉬운 설명
비슷한 변수가 둘 이상 들어가면 서로 설명을 나눠 가지면서 계수가 들쭉날쭉해집니다. 쌍둥이 증인 둘이 같은 이야기를 하면 누구의 증언인지 가리기 어려운 것과 같습니다. 그래서 상관이 아주 높은 쌍에서 하나를 버리고, 그러고도 남은 겹침을 VIF라는 지표로 재서 순차적으로 덜어냅니다.
정의와 수식
VIFⱼ = 1 / (1 − R²ⱼ)      R²ⱼ = 변수 j를 나머지 예측변수로 회귀했을 때의 설명력
제거 규칙: |r| > 0.7 인 쌍에서 후순위 변수 제거 → 이후 max VIF > 5 이면 최댓값 변수 제거, 반복
이 논문에서
LASSO가 고른 24개에 대해 먼저 |r| > 0.7 쌍을 정리하고(LASSO 계수 절댓값이 큰 변수를 우선 보존), 이어 VIF > 5를 반복 제거해 최종 23개를 남겼습니다. Bonferroni 보정의 분모 23은 이 정제 후 개수입니다.
출처: 일반적 회귀 진단 관행. 본 연구 구현은 R car::vif.
5. Post-LASSO와 검증표본 (학교 단위 50:50 분할)
쉬운 설명
출제자가 자기 시험지로 자기를 채점하면 안 됩니다. 변수를 고른 자료에서 그대로 성능을 재면 점수가 부풀기 때문입니다. 그래서 학교를 기준으로 표본을 절반씩 나눠, 한쪽(훈련)에서 변수를 고르고 다른 쪽(검증)에서 예측력을 잽니다. 같은 학교 학생끼리 닮았기 때문에 학생이 아니라 학교 단위로 쪼개야 정보가 새지 않습니다. 고른 변수로 다시 회귀를 적합하는 2단계 방식이 Post-LASSO입니다.
정의와 수식
1단계  S = { j : β̂ⱼ(λ.min) ≠ 0 }            (LASSO로 선택)
2단계  y = Σ_{j∈S} γⱼ xⱼ + ε                (선택 변수만으로 재적합)
검증 R² = 1 − Σ(yᵢ − ŷᵢ)² / Σ(yᵢ − ȳ)²      (검증표본에서 계산)
RMSE   = √( (1/n) Σ(yᵢ − ŷᵢ)² )
이 논문에서
216개교를 무작위로 반씩 갈라 검증표본 108개교·N=1,003을 만들었습니다. 훈련표본 LASSO 모형을 검증표본에 적용한 예측 설명력이 R²≈.085, RMSE≈.234(훈련 교차검증 R²는 .081)입니다. 주 분석의 결측 대체가 분할 이전 전체표본 MICE여서 정보가 스밀 여지가 있었으므로, 훈련표본 전용 중앙값 대체로 다시 계산해 무누수 R² .087을 확인했습니다(누수로 부풀지 않았습니다).
출처: Tibshirani (1996)의 LASSO + 표본분할 관행. 후선택 추론의 한계는 Berk et al. (2013), Lee et al. (2016).
6. 다중분할 50회와 생존율 60% (안정성 선택)
쉬운 설명
한 번 나눈 결과는 그 분할의 운일 수 있습니다. 그래서 학교 단위 50:50 분할을 50번 되풀이하고, 각 회차마다 LASSO가 그 변수를 골랐는지 기록합니다. 50번 중 몇 번 뽑혔는지가 생존율입니다. 이 논문은 60% 이상만 안정 변수로 인정합니다. 우연히 한 번 반짝한 변수는 걸러집니다.
정의와 수식
생존율(j) = (1/B) Σ_{b=1..B} 1[ j ∈ S_b ],   B = 50
안정 변수: 생존율(j) ≥ 0.60
이 논문에서
매 회차 set.seed(2000+r)로 학교 절반을 뽑고, 훈련표본 열별 중앙값으로 결측을 채운 뒤(검증표본 누수 차단) λ.min LASSO를 적합했습니다. 생존율 60% 이상은 18개였습니다(〈표 4〉). 기준을 50/60/70%로 바꾸면 29/17/14개가 되며, 삼중 관문 5변수는 어느 기준에서도 살아남습니다.
중요한 자기 제한: 논문은 이 절차를 Meinshausen & Bühlmann (2010)의 안정성 선택 아이디어에 기대어 수행했으나, "이 생존율은 다중분할의 선택 빈도 집계일 뿐 그들의 오류 통제 절차 자체를 구현한 것은 아니다"라고 Ⅲ.3에 명시합니다.
출처: Meinshausen & Bühlmann (2010).
7. 삼중 관문 (triple gate)
쉬운 설명
증인이 하나면 믿기 어렵습니다. 이 논문은 성격이 다른 세 관문을 모두 통과한 변수만 핵심 요인으로 인정합니다. ① 데이터가 고른 A안에서 유의하고 ② 이론이 배치한 B안 최종 모형에서도 유의하며 ③ 50회 반복 분할에서도 60% 이상 살아남아야 합니다. 통과 기준이 보수적이라, 통과한 목록은 완전한 목록이 아니라 하한입니다.
정의와 수식
관문 1  A안 Post-LASSO 전체표본 재추정에서 p < .05
관문 2  B안 위계적 회귀 M4(89변수)에서 p < .05
관문 3  50회 다중분할 생존율 ≥ 60%
삼중 관문 = 관문1 ∧ 관문2 ∧ 관문3
이 논문에서
통과 변수는 다섯입니다: 과학 과외·학원(94%), 고교 계열(92%), 중3 성적(86%), 수도권 거주(76%), 과학 학습지·통신과외(70%). 고3 영어 내신은 B안에서 p=.060으로 근소하게 미달해 참고 지위입니다. 논문은 '교차검증'이라는 말이 통계학의 k-겹 교차검증과 다르다는 점, 그리고 세 관문이 동일 표본을 공유하므로 서로 독립이 아니라는 점을 Ⅲ.3에 명시합니다.
출처: 본 연구가 구성한 절차(논문 Ⅲ.3 라).
8. 위계적 선형회귀 4영역과 ΔR²
쉬운 설명
이론 심사관 쪽입니다. 변수를 성격별로 네 묶음으로 나누고 한 묶음씩 차례로 넣으면서, 새 묶음이 설명력을 얼마나 더 올리는지(ΔR²)를 봅니다. 학생이 스스로 통제할 수 있는 것(성취·제도·참여)에서 가정이 부여한 조건(가족 배경·지역)으로 나아가는 순서입니다. 다만 순서가 결과를 바꾸므로, 뒤에 들어간 블록의 증분은 그 블록 기여의 하한으로 읽어야 합니다.
정의와 수식
M1: y = X₁β₁ + ε                    (성취·투자,   17변수)
M2: y = X₁β₁ + X₂β₂ + ε             (+제도,       44변수 누적)
M3: … + X₃β₃                        (+학생 참여,  71변수 누적)
M4: … + X₄β₄                        (+가족 배경·지역, 89변수 누적)

ΔR²(단계 k) = R²(Mk) − R²(Mk−1)
수정 R² = 1 − (1 − R²)(n − 1)/(n − p − 1)
블록 결합 Wald: H₀: β_block = 0  →  F 통계량
이 논문에서
R²는 M1 .064 → M2 .083 → M3 .118 → M4 .146(수정 .107)이고, ΔR²는 .064 / .019 / .035 / .028입니다. M3(참여) 블록에 보호자 양육 문항 4개(가정폭력·체벌·애정표현·용기)가 섞여 있어, 이를 가족 배경으로 재태깅하면 순수 참여 .030 / 확장 가족 배경 .034로 순위가 뒤집힙니다. 블록 결합 Wald에서도 순수 참여 F=1.63(p=.046) 대 확장 가족 배경 F=3.87(p<.001)로 격차가 있습니다. 그러나 양육 4문항을 아예 뺀 위계(85변수)에서는 M3·M4가 각 Δ.028로 동률이고, 학교 부트스트랩 500회에서 M4−M3 증분차의 95% 신뢰구간이 [−.013, .030]으로 0을 포함하므로 최대 기여 블록은 판별 유보입니다. B안 최종 모형은 89개 모수 대비 집락 설계 잔차 자유도가 126이어서 개별 계수의 소표본 분산추정에 주의가 필요합니다.
출처: 위계적 회귀의 일반 절차. 블록 구성의 이론 근거는 Boudon (1974), Meyer & Rowan (1977), Bourdieu (1986), Lucas (2001).
9. 복합표본 설계 — 집락(학교)과 비가중
쉬운 설명
같은 학교 학생들은 서로 닮아 있어서, 2,022명을 서로 무관한 2,022개의 관측치로 취급하면 표준오차가 실제보다 작게 나옵니다. 그래서 학교를 집락으로 지정해 이 닮음을 보정합니다. 가중치는 조금 다른 문제입니다. 공개 자료의 9차 가중치는 무응답 보정용이지 패널 마모까지 보정하는 종단 가중치가 아니므로, 주 분석은 가중치를 쓰지 않고 집락만 보정한 뒤 가중 적용은 민감도로 따로 보고합니다.
정의와 수식
설계:  svydesign(id = ~Y16AID, weights = ~1, nest = TRUE)     (집락 = 학교, 비가중)
추정:  svyglm(lnwage ~ X, design = ..., family = gaussian())
급내상관: ICC = σ²_학교 / (σ²_학교 + σ²_개인)
이 논문에서
집락은 학교 식별자(Y16AID)이며, 216개교·평균 9.4명, 로그 월임금의 학교 내 상관은 ICC=.042로 집락 보정을 정당화합니다. 가중 민감도(Y25_WEIGHT 적용)에서 여섯 항목의 계수 방향은 6/6, 유의성은 5/6이 비가중과 일치했고(중3 성적만 가중 시 비유의), 과학 사교육 2종은 가중·비가중 모두 유의했습니다. 표1의 t·χ² 검정은 집락을 반영하지 않은 단순검정임을 표 주에 밝혔습니다.
출처: R survey 패키지. 자료 설계는 한국직업능력연구원 (2026).
10. 결측 대체 — MICE, 중앙값, Rubin 합동
쉬운 설명
설문에는 빈칸이 있습니다. 빈칸이 있는 사람을 모두 버리면 표본이 크게 줄고 편향도 생깁니다. MICE는 다른 변수들을 이용해 빈칸을 그럴듯한 값으로 채우는 방법입니다. 다만 채우기 전에 표본을 나누지 않으면 검증표본 정보가 훈련 쪽으로 샐 수 있어서, 반복 분할에서는 매 회차 훈련표본의 중앙값만 씁니다. 여러 벌을 채워 결과를 합치는 방식(m=20)도 따로 돌려 대체법에 결과가 흔들리지 않는지 확인합니다.
정의와 수식
MICE: 변수별 조건부 모형으로 순환 대체 (본 연구 method = "cart", maxit = 5)
Rubin 합동 (m벌 대체):
   β̄ = (1/m) Σ β̂ₘ
   W = (1/m) Σ SE²ₘ           (대체 내 분산)
   B = (1/(m−1)) Σ (β̂ₘ − β̄)²  (대체 간 분산)
   T = W + (1 + 1/m) B         (총분산),  SE = √T
이 논문에서
주 분석(표2·표3)은 MICE(CART, maxit=5, seed=2026) 단일 대체입니다. 다중분할 50회는 회차별 훈련표본 중앙값 대체입니다. 강건성으로 m=20 다중대체 + Rubin 합동을 돌린 결과 핵심 5변수와 성별이 모두 유의했고 영어 내신만 p=.18로 비유의였습니다. 대체법에 따라 LASSO 선택집합은 달라지지만(MICE 24개 ↔ 중앙값 32~33개) 검증 R²는 .085 ↔ .087로 사실상 같습니다.
출처: Rubin (1987); R mice 패키지.
11. 후선택 추론 — Bonferroni, BH-FDR, 다중분할 집계 p
쉬운 설명
314개 중에서 변수를 고른 바로 그 자료로 다시 p값을 계산하면, 그 p값은 명목 유의수준을 지키지 못합니다. 이미 "잘 맞는 것"만 골라놓고 잘 맞는지 물은 셈이기 때문입니다. 그래서 이 논문은 p값을 확증 근거가 아니라 탐색적 강도 지표로만 쓰고, 발견의 무게를 생존율과 두 경로 동시 통과에 둡니다. 보정을 걸면 얼마나 남는지도 세 가지 방식으로 모두 공개합니다.
정의와 수식
Bonferroni:  p* = p × m,   m = 23 (정제 후 선택 변수 수) → 임계 .05/23 ≈ .0022
BH-FDR:      p₍₁₎ ≤ … ≤ p₍ₘ₎ 정렬,  q₍ᵢ₎ = min_{k≥i} { m·p₍ₖ₎ / k }
다중분할 집계 p (Meinshausen, Meier & Bühlmann 2009):
   회차 b:  p^{adj}_{j,b} = min(1, p_{j,b} × |S_b|)   (미선택 변수는 1)
   Q(γ)   = min(1, quantile_γ { p^{adj}_{j,b} / γ })
   P_j    = min(1, (1 − log γ_min) · min_{γ∈[γ_min,1]} Q(γ)),  γ_min = .05
이 논문에서
- Bonferroni(.0022): 통과한 변수는 성별(p=.0016) 단 하나입니다. 논문은 이 사실을 표2 주에 그대로 적습니다.
- BH-FDR(참고용 관대 보정): 삼중 관문 4개가 q<.05, 과학 통신과외만 q=.060. 다만 선택 이벤트에 조건화하지 않았으므로 "유효 FDR이 아닌 참고용"이라고 못 박습니다.
- 다중분할 집계 p: 전 변수 1.00. 이 절차는 매 회차 훈련표본 λ.min LASSO 선택 변수를 검증표본 집락 회귀로 재추정한 p를 선택집합 크기(평균 43개)로 Bonferroni 보정한 뒤 γ-적응 분위(보정계수 1−log.05 ≈ 4)로 합친 것입니다. 곧 이중 조건과 보정계수 4의 초보수성이 낳은 결과일 수 있어 신호 부재의 확증으로 읽지 않습니다.
- 따라서 삼중 관문의 지위는 "관대한 보정에선 보존되나 엄격한 집계에선 미치지 못하는 탐색적 안정 신호"입니다.
출처: Berk, Brown, Buja, Zhang, & Zhao (2013); Lee, Sun, Sun, & Taylor (2016); Benjamini & Hochberg (1995); Meinshausen, Meier, & Bühlmann (2009).
12. 선택편향과 민감도 — Heckman, Oster, 임금 정의, IPW
쉬운 설명
26세에 전일제로 일하는 사람만 임금이 관측됩니다. 대학원에 있거나 군 복무 뒤 늦게 진입한 사람은 표에 없습니다. 관측된 사람들이 특별한 집단이라면 계수가 왜곡될 수 있습니다. Heckman 2단계는 "관측될 확률"을 먼저 추정해 보정항(역Mills)을 넣는 방법이지만, 선택식에만 들어가고 임금식에는 안 들어가는 변수(배제제약)가 없으면 식별되지 않습니다. Oster δ는 "지금까지 통제한 것만큼 강한 미관측 요인이 있다면 계수가 사라질까"를 따지는 민감도 지표입니다.
정의와 수식
Heckman 2단계
  선택식:  Pr(sel = 1 | z) = Φ(zᵀγ)
  역Mills: λ̂ᵢ = φ(zᵢᵀγ̂) / Φ(zᵢᵀγ̂)
  결과식:  yᵢ = xᵢᵀβ + ρσ λ̂ᵢ + uᵢ      (sel = 1 인 표본만)

Oster (2019)
  δ = β̃ (R̃ − R°) / [ (β° − β̃)(R_max − R̃) ]
  β* = β̃ − (β° − β̃)(R_max − R̃)/(R̃ − R°)
  β°,R° = 통제 없는 모형 / β̃,R̃ = 통제 포함 모형 / R_max = 가정하는 최대 설명력
  판단: δ > 1 이면 "관측 통제만큼 강한 미관측 요인이 있어야 계수가 사라짐"

IPW:  wᵢ = 1 / P̂(sel = 1 | zᵢ)
이 논문에서
- Heckman 두 사양 병기: 10변수 사양 λ=+.180(p=.877)이고 핵심 변수가 비유의인 반면, 12변수 사양은 λ=−.938(p=.398)이고 과외 .007·통신 .042·계열 .004·수도권 .040이 유의합니다. λ의 부호까지 사양에 따라 뒤집힌다 → 비식별이므로 판단 보류. 표준오차는 집락·생성회귀변수 미보정 OLS 기준임도 밝힙니다.
- Oster δ: Rmax=1.3R̃에서 과외 4.33·통신 3.52·계열 3.29로 모두 1을 크게 넘지만, 2R̃에서 계열이 0.99로 내려가고 3R̃에서는 셋 다 1 미만이 된다 → 관례적 Rmax 선택에 조건부.
- 관측 기반 진단: 마모 탈락자는 중3 성적·영어 내신이 낮았고(표준화 차이 .14~.17), 취업 단계에서는 남성(−.29)·부모 학력 상위층(−.11)이 미진입 쪽에 많았습니다(상위 배경의 지연 진입과 부합). IPW 재적합에서도 삼중 관문 5변수와 영어 내신의 방향·유의성이 유지되나, 선택모형 설명력이 낮아(McFadden R²=.007) 비관측 선택은 배제할 수 없습니다.
- 임금 정의 민감도: 시간당 임금(N=2,217)에서 네 변수(과학 과외·학원·영어 내신·계열·수도권)는 유의하나 통신과외 p=.050·중3 성적 p=.052로 경계입니다. 근무시간을 직접 통제한 사양에서는 여섯 변수가 모두 유의했습니다(근무시간 +.005, p=.002).
- 잠재경력 통제: 경력(=9 − 첫 전일제 응답 차수, 평균 1.85년)을 넣어도 삼중 관문 변수와 영어 내신이 모두 생존했습니다(경력 자체 +.012, p<.001).
- 추가 통제: 성별과 부모 학력을 넣어도 핵심 계수는 거의 불변이며 부·모 학력은 비유의(부 p=.235)였다 → 과학 사교육 자본이 부모 학력으로 환원되지 않습니다.
출처: Heckman (1979); Oster (2019).
발표 후 질의응답에 대비해 정리한 36개 문답입니다. 분류를 고르거나 검색어를 넣어 좁힐 수 있습니다.
1. 인적자본론 — Becker (1964)
핵심 명제
교육과 훈련은 개인의 생산성을 높이는 자본 축적이며, 그 생산성이 노동시장에서 임금으로 보상받습니다. 고교 시기의 학업성취와 학습 노력은 축적된 인적자본의 지표로 읽힙니다.
이 논문에서의 역할
성취·투자 영역(M1: 내신·학습 시간·학습 태도)의 정적 효과를 기대하는 근거입니다(Ⅱ.1). 결과적으로 이 예측은 부분 지지됩니다. 능력·구조 신호(고교 계열·중3 성적·수도권, 참고 지위의 영어 내신)가 전일제 취업 선택을 조건으로 초기 임금에 새겨진 것으로 보이기 때문입니다(Ⅴ.2). 다만 M1의 ΔR²는 .064이고 전체 설명력이 낮아, 인적자본 경로만으로 초기 임금을 설명하기는 어렵습니다.
출처: Becker, G. S. (1964). Human Capital: A Theoretical and Empirical Analysis. Columbia University Press.
2. 신호이론 — Spence (1973)
핵심 명제
정보 비대칭 아래에서 고용주는 지원자의 생산성을 직접 볼 수 없으므로, 학력·성취처럼 관측 가능한 자격을 능력과 성실성의 신호로 활용합니다. 따라서 성취 지표는 생산성의 증명이 아니어도 선별 단서로서 보상받을 수 있습니다.
이 논문에서의 역할
인적자본론과 기제는 다르지만 '학생의 노력·능력이 임금으로 연결된다'는 예측에서 수렴하므로, 두 이론을 함께 M1 영역의 근거로 삼습니다(Ⅱ.1). 본 연구가 다루는 것은 관측 자격의 축입니다. 논문은 고용주가 시간이 지나며 비관측 능력을 학습한다는 별도 가설을 검토 대상으로 삼지 않으며, 단일 시점 설계에서는 그 구분이 식별되지 않는다는 점을 전제로 둡니다.
출처: Spence, M. (1973). Job market signaling. Quarterly Journal of Economics, 87(3), 355–374.
3. 문화·경제자본 — Bourdieu (1986)
핵심 명제
가정의 경제자본은 체화된 문화자본으로 전환되고, 이 문화자본은 학교가 요구하는 능력과 친화적이어서 교육성취로 제도화되며, 학력 자격으로 공인된 뒤 노동시장에서 보상으로 재전환됩니다. 곧 임금 격차의 일부는 교육 이전에 가정에 배분된 자본의 표현입니다.
이 논문에서의 역할
임금 격차를 노력·능력의 결과로만 보는 인적자본·신호이론에 대한 대항 축입니다(Ⅱ.2). 결정적 사용 지점은 Ⅴ.2입니다. 검증을 통과한 과학 사교육 중 저비용인 학습지·통신과외에서도 뚜렷한 계층 기울기가 나타났으므로(부모 학력 OR 1.26/1.30), 작동하는 자본이 지출 규모보다 정보·관리·과목 정렬 능력, 곧 문화자본에 가깝다고 해석합니다. 다만 같은 문장에서 이 기울기가 정보 접근성이나 지역별 공급 차로도 설명될 수 있다는 경합 해석을 병기합니다.
출처: Bourdieu, P. (1986). The forms of capital. In J. G. Richardson (Ed.), Handbook of Theory and Research for the Sociology of Education (pp. 241–258). Greenwood.
4. 효과적으로 유지되는 불평등(EMI) — Lucas (2001)
핵심 명제
교육이 양적으로 보편화되어 이수 여부가 더 이상 계층을 변별하지 못하면, 상위 계층은 우위를 단계 내부의 질적 차이로 옮깁니다. 변별의 축이 진학 여부에서 어떤 트랙·전공·교과 경로와 그 투자로 이동한다는 것입니다.
이 논문에서의 역할
사교육을 총량이 아니라 과목·형태별 정렬로 보아야 하는 이론적 근거입니다(Ⅱ.2). 총량 축에서 무효과를 보고한 선행연구와 본 연구의 과목 정렬형 발견이 양립하는 이유도 여기서 나옵니다(Ⅱ.4, Ⅴ.2). 동시에 이 논문에서 가장 강한 긴장을 만드는 이론이기도 합니다. EMI대로라면 문·이과 선택에 SES 기울기가 나타나야 하지만 이과 계열은 OR 1.03으로 기울기가 없었고, 논문은 이를 은폐하지 않고 Ⅴ.2에 반례로 제시합니다.
출처: Lucas, S. R. (2001). Effectively maintained inequality: Education transitions, track mobility, and social background effects. American Journal of Sociology, 106(6), 1642–1690.
5. 그림자교육 — Bray (1999)
핵심 명제
정규 교육과정을 보강하는 학교 밖 사교육은 정규 교육의 그림자처럼 따라붙되, 지불 능력에 따라 접근이 차등화되어 계층 격차를 재생산합니다.
이 논문에서의 역할
사교육을 계층 재생산의 통로로 개념화하는 근거이며(Ⅱ.2), 한국 맥락에서는 교육열의 제도화(오욱환, 2000)와 연결됩니다. 본 연구의 표7이 바로 이 명제를 직접 검정한 부분입니다. 검증 통과 과학 사교육 2종의 경험은 부모 학력 +1SD당 OR 1.26~1.41, 부 월소득 +1SD당 1.39~1.53으로 높아졌습니다. 다만 넓게 정의한 노출에서는 기울기가 미약해(OR 1.08), 계층화된 것은 사교육 일반이 아니라 특정 형태라는 단서가 붙습니다.
출처: Bray, M. (1999). The Shadow Education System: Private Tutoring and Its Implications for Planners. UNESCO IIEP.
6. 합리적 선택과 이차 효과 — Boudon (1974)
핵심 명제
교육 불평등은 능력 차이에서 오는 일차 효과와, 같은 성적이라도 가정의 자원·정보에 따라 위험 회피와 기대 편익이 달라져 발생하는 이차 효과로 나뉩니다. 본 연구가 사용하는 것은 이차 효과 쪽입니다.
이 논문에서의 역할
내신 경쟁력을 높이고 학습에 시간을 투자하는 행위를 미래를 겨냥한 비용-편익 판단의 산물로 보아, 학생이 통제할 수 있는 변수를 성취·투자 영역(M1)으로 묶을 근거가 됩니다(Ⅱ.3). 또한 위계적 투입에서 M4의 증분을 가족 배경 기여의 하한으로 읽어야 하는 이유이기도 합니다. 가족 배경을 경유해 형성된 분산이 앞 블록에 선귀속되기 때문입니다. Ⅴ.2에서는 이과 계열 무기울기가 이차 효과 예측과 긴장한다는 점을 밝힙니다.
출처: Boudon, R. (1974). Education, Opportunity, and Social Inequality. Wiley.
7. 이완결합 — Meyer & Rowan (1977)
핵심 명제
조직의 제도적 형식은 정당성을 얻기 위한 신화와 의례로 채택되며, 실제 활동·성과와는 느슨하게만 결합됩니다. 형식의 존재가 곧 성과의 존재를 뜻하지 않습니다.
이 논문에서의 역할
학교 제도를 학생 개인의 선택과 분리해 별도 영역(M2)으로 세울 근거입니다(Ⅱ.3). 결과적으로 M2 블록은 증분이 작고(ΔR²=.019) 투입 변수 대부분이 비유의했는데, 논문은 이를 이완결합 명제와 부합한다고 읽되 사전 가설이 아니라 사후 정합임을 같은 문장에서 명시합니다(Ⅳ.3). 아울러 M2 변수들이 학교 제도 자체가 아니라 제도에 대한 학생의 지각임을 밝혀 과대 해석을 막습니다.
출처: Meyer, J. W., & Rowan, B. (1977). Institutionalized organizations: Formal structure as myth and ceremony. American Journal of Sociology, 83(2), 340–363.
8. 능력주의 신화 — Young (1958); McNamee & Miller (2009)
핵심 명제
능력주의는 지위와 보상이 능력과 노력에 비례해 배분되는 체제를 뜻합니다. Young은 이 말을 만들면서 이미 풍자로 썼고, McNamee와 Miller는 상속·가족 자원·연결망 같은 비능력 요인이 실제 배분을 좌우한다고 논합니다.
이 논문에서의 역할
능력주의 판정의 범위를 제한하는 장치로 쓰입니다(Ⅴ.3). 논문은 능력주의의 실질 요건을 ① 능력 신호가 보상과 연결되는가 ② 능력 형성 기회가 균등한가로 나눈 뒤, 본 연구가 ①의 일부만 다루었고 보상이 능력 격차에 비례하는지는 검토하지 않았다고 밝힙니다. 따라서 결론은 '능력 신호의 실재는 시사되나 능력주의 성립 여부는 본 설계에서 판정되지 않는다'이며, 정책 함의는 판정되지 않은 ①이 아니라 확인된 ②의 불평등에 둡니다.
출처: Young, M. (1958). The Rise of the Meritocracy. Thames and Hudson. / McNamee, S. J., & Miller, R. K. (2009). The Meritocracy Myth (2nd ed.). Rowman & Littlefield.
9. 집중양육 — Lareau (2011)
핵심 명제
중산층 가정은 자녀의 재능을 계획적으로 계발하는 집중양육을 실천하고, 노동계급·빈곤층 가정은 자연적 성장에 맡기는 경향이 있습니다. 그 결과 제도(학교·기관)를 다루는 역량 자체가 계급에 따라 차등화됩니다.
이 논문에서의 역할
Ⅴ.2에서 과학 사교육 접근 기울기의 해석을 보강합니다. 작동하는 자본이 지출 규모보다 정보·관리·과목 정렬 능력에 가깝다는 해석이, 계급별 양육이 제도 대응 역량을 차등화한다는 이 이론과 통한다는 것입니다. 저비용 형태(학습지·통신과외)에서도 계층 기울기가 나타났다는 관측이 이 연결의 실증적 고리입니다.
출처: Lareau, A. (2011). Unequal Childhoods: Class, Race, and Family Life (2nd ed.). University of California Press.
부기: 네 영역 분석틀의 지위
논문은 성취·투자(M1)·제도(M2)·학생 참여(M3)·가족 배경·지역(M4)의 네 영역이 고차원 변수를 조직·투입하기 위한 장치이며 이론적 실체 범주가 아니라고 Ⅱ.3에 명시합니다. 임금에 남는 신호의 해석틀은 Ⅴ장에서 두 갈래로 따로 정식화됩니다.
- 접근이 계층화된 사교육 자본 (과학 과외·학원, 과학 학습지·통신과외)
- 형성에 기울기가 있는 능력·구조 신호 (고교 계열, 중3 성적, 수도권 거주; 참고 지위의 영어 내신)
이 '이원 구조'라는 이름도 사전 이론 범주가 아니라 결과 패턴을 요약한 서술적 라벨이며, '능력·구조 신호'도 성취 지표(중3 성적)와 구조 위치(계열·수도권)를 편의상 묶은 이름일 뿐 둘의 동일 기제를 주장하지 않습니다(Ⅴ.2).
발표 보조 사이트 「코드」 영역 콘텐츠. 실제 분석 스크립트에서 원문 그대로 발췌했습니다. 스크립트 위치: C:\Claude\105 한국 직업능력 연구원 학술지 쓰기(대회용_9차 포함)\R분석\ 산출 위치: 같은 폴더의 결과_9차/. 난수 시드는 2026(다중분할은 회차별 2000+r)으로 고정되어 있습니다.
1. 표본·종속변수 구축 (9차 월임금 통합구성·윈저화)
9차 원자료의 임금 블록을 통합변수명으로 바꾸고 음수 결측코드를 NA로 정리해 보관합니다.
# ── (4) select → 라벨 제거·numeric → 임금블록 음수 결측코드 NA → 리네임 → WAVE=9 ─
block <- raw9 %>% select(all_of(c(wage_src, id_src)))
block[wage_src] <- lapply(block[wage_src], naneg)   # 임금블록: 음수→NA
block[id_src]   <- lapply(block[id_src],   num)     # ID·가중치: 라벨 제거 numeric(음수 처리 안 함)
names(block)[match(wage_src, names(block))] <- unname(map[wage_src])  # Y25SH02XXX → L08J302XXX
block$WAVE <- 9L

saveRDS(block, OUTRDS)
cat(sprintf("▶ 저장: %s (%d행 × %d열)\n", OUTRDS, nrow(block), ncol(block)))
급여형태(연봉·월·주·일·시)에 맞추어 월액으로 환산·통합하고, 50~1,500만원 절단과 전일제(주 35시간) 필터를 건 뒤 1·99 분위 윈저화하고 자연로그를 취합니다.
# ── (3) 종속변수: 월임금(통합구성, 로그) ─────────────────────────────────────
pay<-naneg(raw$L08J302033); ann<-naneg(raw$L08J302034); mon<-naneg(raw$L08J302035)
wk <-naneg(raw$L08J302036); dy <-naneg(raw$L08J302037); hr <-naneg(raw$L08J302038)
hrs<-naneg(raw$L08J302031); dys<-naneg(raw$L08J302030); inc<-naneg(raw$L08J302039)
mw_form <- dplyr::case_when(
  pay==1 ~ ann/12, pay==2 ~ mon, pay==3 ~ wk*4.345,
  pay==4 ~ dy*ifelse(is.na(dys),5,dys)*4.345,
  pay==5 ~ hr*ifelse(is.na(hrs),40,hrs)*4.345, TRUE ~ NA_real_)
mw <- dplyr::coalesce(mw_form, inc, mon, ann/12, hr*ifelse(is.na(hrs),40,hrs)*4.345)

wdf <- data.frame(Y16SID=raw$Y16SID, WAVE=W, mw=mw, hrs=hrs) %>%
  filter(WAVE==TARGET_WAVE, mw>=WAGE_FLOOR, mw<=WAGE_CEIL)
if (SAMPLE=="fulltime") wdf <- wdf %>% filter(!is.na(hrs), hrs>=35)
q <- quantile(wdf$mw, WINSOR, na.rm=TRUE); wdf$mw <- pmin(pmax(wdf$mw, q[1]), q[2])
wage_df <- wdf %>% mutate(lnwage=log(mw)) %>% select(Y16SID, mw, lnwage)
2. 결측 대체 (MICE, CART)
주 분석(표2·표3)의 단일 대체입니다. quickpred(mincor=0.1)로 예측자 행렬을 줄이고 CART로 m=1 대체한 뒤, 남은 결측은 중앙값으로 메웁니다. 다중대체 m=20·Rubin 합동은 별도 스크립트 87_mice_pooled.R에서 수행했습니다.
# ── (5) 결측 대체 (MICE 또는 중앙값) ─────────────────────────────────────────
cat(sprintf("\n▶ 결측대체: %s\n", ifelse(USE_MICE,"MICE(CART, maxit=5)","중앙값")))
impute_df <- function(df, keep){
  X <- df %>% select(-any_of(keep))
  if (USE_MICE){
    pm <- mice::quickpred(X, mincor=0.1)
    im <- mice::mice(X, m=1, method="cart", predictorMatrix=pm, seed=SEED, printFlag=FALSE)
    Xc <- mice::complete(im, 1)
  } else Xc <- X
  Xc <- Xc %>% mutate(across(everything(), ~ ifelse(is.na(.), median(.,na.rm=TRUE), .)))
  bind_cols(df %>% select(any_of(keep)), Xc)
}
keepA <- c(admin,"is_test")
t0<-proc.time()["elapsed"]; adfA <- impute_df(adfA, keepA); adfB <- impute_df(adfB, admin)
3. A안 LASSO 적합 (cv.glmnet)
훈련절반에서 10겹 교차검증으로 λ.min을 잡아 비영 계수를 고르고, 그 모형을 검증절반에 적용해 예측 R²·RMSE를 잽니다.
# ── (6) A안 Post-LASSO (gaussian) ────────────────────────────────────────────
cat("\n===== A안: Post-LASSO (gaussian) =====\n")
X <- adfA %>% select(-any_of(keepA)) %>% as.matrix()
X <- X[, apply(X,2,function(c) var(c,na.rm=TRUE)>0), drop=FALSE]
y <- adfA$lnwage; w <- adfA$Y16_WEIGHT; tf <- adfA$is_test
wn <- (w[!tf])/sum(w[!tf])*sum(!tf)
cv <- cv.glmnet(X[!tf,], y[!tf], family="gaussian", alpha=1, weights=wn, nfolds=10, standardize=TRUE)
cf <- coef(cv, s=cv$lambda.min)
sel <- setdiff(rownames(cf)[as.matrix(cf)[,1]!=0], "(Intercept)")
predte <- as.numeric(predict(cv, newx=X[tf,], s="lambda.min"))
cvr2 <- 1 - min(cv$cvm)/var(y[!tf]); ter2 <- wr2(y[tf],predte); termse <- rmse(y[tf],predte)
cat(sprintf("▶ LASSO 선택(λ.min) %d개 | 훈련 CV R²≈%.4f | 검증표본 R²=%.4f, RMSE=%.4f\n",
  length(sel), cvr2, ter2, termse))
4. 다중공선성 정제(|r|>0.7, VIF>5)와 집락 보정 회귀
정제 함수 둘. 상관 0.7 초과 쌍에서 후순위를 버리고, 그러고도 VIF가 5를 넘으면 최댓값 변수를 반복 제거합니다.
remove_high_cor <- function(M, priority, thr = 0.7){
  v <- colnames(M); keep <- c(priority[priority %in% v], setdiff(v, priority))
  cm <- cor(M[, keep, drop=FALSE], use="pairwise.complete.obs"); rm_ <- character(0)
  for (i in seq_along(keep)) if (!keep[i] %in% rm_)
    for (j in seq_along(keep)) if (i<j && !keep[j] %in% rm_ &&
        !is.na(cm[keep[i],keep[j]]) && abs(cm[keep[i],keep[j]])>thr) rm_<-c(rm_,keep[j])
  setdiff(keep, rm_)
}
remove_high_vif_lm <- function(fit0, design, outcome, thr=5, maxit=30){
  fit<-fit0; it<-0
  repeat{ it<-it+1; vf<-tryCatch(car::vif(fit), error=function(e) NULL)
    if (is.null(vf)) break; if (is.matrix(vf)) vf<-vf[,1]
    if (max(vf)<=thr || it>maxit) break
    worst<-names(which.max(vf)); tm<-setdiff(attr(terms(fit),"term.labels"),worst)
    if(!length(tm)) break
    fit<-svyglm(as.formula(paste(outcome,"~",paste(tm,collapse="+"))),design=design,family=gaussian())
  }; fit
}
drop_const <- function(vars, data, k=2)
이어 선택·정제된 변수로 집락(학교) 보정 선형회귀를 적합해 표2의 계수·p를 산출합니다(전체표본 선택후 재추정).
sigA <- data.frame()
if (length(sel)>=2){
  prio <- names(sort(abs(as.matrix(cf)[sel,1]), decreasing=TRUE))
  surv <- remove_high_cor(as.data.frame(X[tf,sel,drop=FALSE]), prio)
  dfit <- adfA; names(dfit) <- make.names(names(dfit), unique=TRUE)
  surv2 <- drop_const(make.names(surv,unique=TRUE), dfit)
  desA <- svydesign(id=~Y16AID, weights=~Y16_WEIGHT, data=dfit, nest=TRUE)
  f0 <- svyglm(as.formula(paste("lnwage~",paste(surv2,collapse="+"))), design=desA, family=gaussian())
  fA <- remove_high_vif_lm(f0, desA, "lnwage")
  co <- summary(fA)$coefficients
  sigA <- data.frame(변수=rownames(co), 라벨=sapply(rownames(co),labof),
    계수=round(co[,1],4), SE=round(co[,2],4), t=round(co[,3],3), p=round(co[,4],4),
    row.names=NULL) %>% filter(변수!="(Intercept)") %>% arrange(p)
  cat(sprintf("▶ A안 정제후 %d개 | 유의(p<.05) %d개\n",
    length(attr(terms(fA),"term.labels")), sum(sigA$p<0.05)))
  print(head(sigA[sigA$p<0.05,], 20), row.names=FALSE)
5. 다중분할 50회 안정성
학교 단위 50:50 분할을 50번 반복합니다. 매 회차 훈련표본 열별 중앙값으로만 결측을 메워 검증표본 누수를 차단하며, 선택 빈도를 생존율로 집계합니다. 주석에 MICE를 쓰지 않은 이유(314개 공선 변수에서 특이행렬)가 명시되어 있습니다.
# [중요] 매 회차 '훈련표본 기반 중앙값'으로 결측대체.
#  - pmm/MICE는 314개 공선 변수에서 역행렬이 특이(singular)가 되어 실패하므로 사용하지 않음.
#  - 훈련표본 중앙값만 사용 → 검증표본 정보 누수 차단 + 계산 안정 + 50회 수 초 완료.
acc <- character(0); t0<-proc.time()["elapsed"]
baseA <- bind_cols(adm, nonA)
Xr0 <- baseA %>% select(-any_of(admin)) %>% as.data.frame()
for (r in seq_len(N_REPEAT)){
  set.seed(2000+r)
  tsr <- baseA$Y16AID %in% sample(schools, floor(0.5*length(schools)))
  med_tr <- vapply(Xr0, function(col) median(col[!tsr], na.rm=TRUE), numeric(1))
  Xc <- Xr0
  for (j in seq_along(Xc)) { m <- med_tr[j]; if (is.na(m)) m <- 0
    v <- Xc[[j]]; v[is.na(v)] <- m; Xc[[j]] <- v }
  M <- as.matrix(Xc); M <- M[, apply(M, 2, function(c) var(c[!tsr])>0), drop=FALSE]
  yr <- baseA$lnwage; wr <- baseA$Y16_WEIGHT
  wnr <- (wr[!tsr])/sum(wr[!tsr])*sum(!tsr)
  cvr <- cv.glmnet(M[!tsr,], yr[!tsr], family="gaussian", alpha=1, weights=wnr, nfolds=10, standardize=TRUE)
  cfr <- coef(cvr, s=cvr$lambda.min)
  pr <- setdiff(rownames(cfr)[as.matrix(cfr)[,1]!=0], "(Intercept)")
  if (length(pr)) acc <- c(acc, pr)
  if (r %% 10 == 0) cat(sprintf("  [%02d/%02d] 누적 %s\n", r, N_REPEAT, fmt_sec(proc.time()["elapsed"]-t0)))
}
6. B안 위계적 회귀와 ΔR²
집락 보정 가우시안 svyglm을 M1→M4 순으로 적합하며 단계별 R²·수정 R²·ΔR²를 쌓습니다.
cat("\n===== B안: 위계 선형회귀 (gaussian) =====\n")
desB <- svydesign(id=~Y16AID, weights=~Y16_WEIGHT, data=adfB, nest=TRUE)
av <- function(v) drop_const(intersect(v, names(adfB)), adfB)
a1<-av(vars_m1); a2<-av(vars_m2); a3<-av(vars_m3); a4<-av(vars_m4)
blocks <- list(M1=a1, M2=c(a1,a2), M3=c(a1,a2,a3), M4=c(a1,a2,a3,a4))
hier <- data.frame(); prevR<-0; fitM4<-NULL
for (nm in names(blocks)){
  vv <- unique(blocks[[nm]]); if(!length(vv)) next
  fit <- svyglm(as.formula(paste("lnwage~",paste(vv,collapse="+"))), design=desB, family=gaussian())
  if (nm=="M4") fitM4 <- fit
  yh <- as.numeric(predict(fit, type="response"))
  R2 <- wr2(adfB$lnwage, yh, adfB$Y16_WEIGHT); aR2 <- adjr2(R2, nrow(adfB), length(vv))
  hier <- rbind(hier, data.frame(모형=nm, 투입변수=length(vv),
    R2=round(R2,4), 수정R2=round(aR2,4), ΔR2=round(R2-prevR,4))); prevR<-R2
}
print(hier, row.names=FALSE)
7. Heckman 2단계 (12변수 사양)
선택식을 프로빗으로 적합해 역 Mills 비율을 만들고, 임금식에 넣어 보정 전후를 비교합니다. 배제제약이 없어 식별되지 않으므로 논문은 10변수(72_heckman_w9.R)·12변수 두 사양을 병기하고 판단을 보류합니다.
preds<-intersect(preds,names(ghs))
heck<-ghs%>%filter(Y16SID%in%ids_w9)%>%select(Y16SID,any_of(preds))%>%mutate(across(-Y16SID,~ifelse(num(.)<0,NA,num(.))))
heck<-left_join(heck,wage_df,by="Y16SID");heck$sel<-as.integer(!is.na(heck$lnwage))
heck[preds]<-medfill(heck[preds])
cat(sprintf("Heckman(12변수) universe N=%d, 선택(전일제 임금)=%d (%.1f%%)\n",nrow(heck),sum(heck$sel),mean(heck$sel)*100))
rhs<-paste(preds,collapse="+")
p1<-glm(as.formula(paste("sel ~",rhs)),family=binomial("probit"),data=heck)
xb<-predict(p1,type="link"); heck$imr<-dnorm(xb)/pnorm(xb)
sub<-heck[heck$sel==1,]
o0<-lm(as.formula(paste("lnwage ~",rhs)),data=sub)
o1<-lm(as.formula(paste("lnwage ~",rhs,"+ imr")),data=sub)
co<-summary(o1)$coefficients
cat("\n[Heckman 2단계·12변수] 결과식(역Mills 포함) 계수\n"); print(round(co,4))
imr_p<-co["imr","Pr(>|t|)"]; imr_b<-co["imr","Estimate"]
cat(sprintf("\n역Mills(λ) 계수=%.4f, p=%.4f → %s\n",imr_b,imr_p,
  ifelse(imr_p<0.05,"선택편향 유의","비유의=검정력부족·판단보류(식별 취약)")))
8. Oster δ 민감도
무통제 모형(β°, R°)과 전체통제 모형(β̃, R̃)을 비교해, 가정하는 최대 설명력 Rmax 세 수준(1.3·2·3배)에서 δ와 β*를 산출합니다.
# β°,R°,β̃,R̃ 산출 후 Rmax 3수준 δ·β*
osterbase<-function(target){ ctrl<-intersect(setdiff(m4v,target),names(D))
  fs<-lm(as.formula(paste("lnwage ~",target)),data=D); b0<-coef(fs)[[target]]; R0<-summary(fs)$r.squared
  fl<-lm(as.formula(paste("lnwage ~",paste(c(target,ctrl),collapse="+"))),data=D); bt<-coef(fl)[[target]]; Rt<-summary(fl)$r.squared
  list(b0=b0,R0=R0,bt=bt,Rt=Rt) }
RES<-list()
for(t in c("L08H104018","L08H104019","L08H101009")){ o<-osterbase(t)
  cat(sprintf("\n[%s] β°=%.4f R°=%.4f | β̃=%.4f R̃=%.4f\n", t,o$b0,o$R0,o$bt,o$Rt))
  for(mult in c(1.3,2,3)){ Rmax<-min(1, mult*o$Rt)
    delta<-o$bt*(o$Rt-o$R0)/((o$b0-o$bt)*(Rmax-o$Rt))
    bstar<-o$bt-(o$b0-o$bt)*(Rmax-o$Rt)/(o$Rt-o$R0)
    cat(sprintf("   Rmax=%.2fR̃=%.4f → δ=%.3f, β*(δ=1)=%.4f  [%s]\n",
      mult,Rmax,delta,bstar, ifelse(delta<1,"δ<1 취약","δ>1 강건")))
    RES[[length(RES)+1]]<-data.frame(변수=t, 라벨=lab(t),
      β_무통제=round(o$b0,4), R2_무통제=round(o$R0,4), β_전체통제=round(o$bt,4), R2_전체통제=round(o$Rt,4),
      Rmax수준=sprintf("%.1fR̃",mult), Rmax값=round(Rmax,4),
      delta_δ=round(delta,3), bstar_δ1=round(bstar,4),
      판정=ifelse(delta<1,"δ<1(OVB 취약)","δ≥1(강건)")) }}
9. 후선택 추론: BH-FDR과 다중분할 집계 p
먼저 A안 선택후 p에 BH 절차를 적용합니다(선택 이벤트 미조건화 → 참고용 관대 보정).
# ── (a) BH-FDR on A_LASSO_sig.csv ────────────────────────────────────────────
sig<-tryCatch(read.csv(paste0(OUT,"A_LASSO_sig.csv"),fileEncoding="UTF-8",check.names=FALSE),error=function(e)NULL)
bhq<-setNames(rep(NA_real_,length(report_vars)),report_vars)
sel_p<-setNames(rep(NA_real_,length(report_vars)),report_vars)
if(!is.null(sig) && nrow(sig)){
  vcol<-sig[[1]]; pcol<-as.numeric(sig[[which(tolower(names(sig))=="p")[1]]]); if(all(is.na(pcol))) pcol<-as.numeric(sig[[ncol(sig)]])
  q_all<-p.adjust(pcol, method="BH")
  cat(sprintf("(a) A_LASSO_sig %d변수 BH-FDR 보정\n", length(pcol)))
  for(v in report_vars){ i<-which(vcol==v); if(length(i)){ sel_p[v]<-pcol[i[1]]; bhq[v]<-q_all[i[1]] } }
  print(data.frame(변수=vcol, 선택후p=round(pcol,4), BHq=round(q_all,4)))
다음은 Meinshausen 파이프라인입니다. 회차마다 훈련절반에서 고르고 검증절반에서 p를 재추정한 뒤 선택집합 크기로 Bonferroni 보정합니다(미선택은 p=1).
# ── (b) 다중분할 Meinshausen 집계 (무누수: 훈련중앙값) ───────────────────────
B<-50; allv<-colnames(nonA); Xr0<-as.data.frame(nonA)
padj<-matrix(1, nrow=length(allv), ncol=B, dimnames=list(allv,NULL))
selsize<-integer(B); okb<-0
for(b in 1:B){
  set.seed(2000+b)
  tf<-aid %in% sample(schools, floor(0.5*length(schools)))   # 검증(추론) 절반
  med<-vapply(Xr0, function(c) median(c[!tf],na.rm=TRUE), numeric(1))
  Xc<-Xr0; for(j in seq_along(Xc)){m<-med[j];if(is.na(m))m<-0;v<-Xc[[j]];v[is.na(v)]<-m;Xc[[j]]<-v}
  M<-as.matrix(Xc); kc<-apply(M,2,function(c) var(c[!tf])>0); M<-M[,kc,drop=FALSE]
  cv<-cv.glmnet(M[!tf,], y[!tf], family="gaussian", alpha=1, nfolds=10, standardize=TRUE)
  cf<-coef(cv,s="lambda.min"); sel<-setdiff(rownames(cf)[as.matrix(cf)[,1]!=0],"(Intercept)")
  sel<-intersect(sel, colnames(M)); selsize[b]<-length(sel); if(!length(sel)) next
  vdf<-as.data.frame(M[tf, sel, drop=FALSE]); names(vdf)<-sel
  vdf$lnwage<-y[tf]; vdf$Y16AID<-aid[tf]; vdf$ones<-1
  fit<-tryCatch(svyglm(as.formula(paste("lnwage ~",paste(sel,collapse="+"))),
    design=svydesign(id=~Y16AID,weights=~ones,data=vdf,nest=TRUE), family=gaussian()),
    error=function(e) NULL)
  if(is.null(fit)) next
  co<-summary(fit)$coefficients; okb<-okb+1
  ps<-setNames(rep(1,length(sel)),sel); for(v in sel) if(v%in%rownames(co)) ps[v]<-co[v,4]
  padj[sel,b]<-pmin(1, ps*length(sel))
}
마지막으로 γ-적응 분위로 합치고(보정계수 1−log0.05≈4), 참고용 선택빈도를 따로 산출합니다. 이 선택빈도(2~26%)가 표4 생존율(60~94%)과 다른 지표인 이유가 바로 padj<1이라는 이중 조건 때문입니다.
cat(sprintf("(b) 다중분할 %d회 중 svyglm 성공 %d회, 평균 선택집합 %.1f개\n", B, okb, mean(selsize[selsize>0])))
gmin<-0.05; gg<-seq(gmin,1,by=0.025)
aggp<-sapply(allv, function(v){ pv<-padj[v,]
  Q<-sapply(gg, function(g) min(1, as.numeric(quantile(pv/g, probs=g, names=FALSE, type=1))))
  min(1, (1-log(gmin))*min(Q)) })
sel_freq<-rowMeans(padj<1)   # 선택 빈도(참고)
10. [그림 2] 생성 (9차 단독 ΔR²)
수치를 하드코딩하지 않고 산출 CSV에서 읽으며, 기댓값과 어긋나면 stopifnot으로 즉시 중단하는 자가검증이 들어 있습니다.
# ── CSV에서 9차 ΔR² 읽기 (ΔR2 = 5번째 열, 인코딩 무관 인덱스 접근) ─────────────
d9  <- read.csv(paste0(OUT,"B_hierarchy_deltaR2.csv"), fileEncoding="UTF-8")
dr9 <- as.numeric(d9[[5]])
lab <- c("M1\n합리적선택","M2\n+제도","M3\n+학생참여","M4\n+가족SES·지역")

# ── 자가검증: 기대값 부합 (M1≈.064/M2≈.019/M3≈.035/M4≈.028), 다르면 중단 ──────
exp <- c(0.064, 0.019, 0.035, 0.028)
stopifnot(length(dr9) == 4, all(abs(dr9 - exp) < 0.002))
cat("[검증] 9차 ΔR²:",
    paste(sprintf("%s=%.4f", c("M1","M2","M3","M4"), dr9), collapse="  "), "\n")

# ── 그림2 단독: 블록별 ΔR² 9차 단독 막대 (74 그림2부 스타일) ───────────────────
png(paste0(OUT,"Figure2_hierarchy_dR2_w9only.png"), 2200, 1400, res=300)
par(mar=c(4,4.5,3,1))
bp <- barplot(dr9, names.arg=lab, col="#ffc24d", ylim=c(0,max(dr9)*1.35),
   ylab="증분 ΔR² (로그 월임금)", main="위계 영역별 증분 ΔR² (9차·약26세)")
text(bp, dr9, labels=formatC(dr9, format="f", digits=3), pos=3, cex=0.75)
dev.off()
cat("저장: Figure2_hierarchy_dR2_w9only.png\n")
스크립트 대장 (산출은 모두 결과_9차/)
| 번호 | 파일 | 역할 |
|---|---|---|
| 60 | 60_wave9_build.R | 9차 SAV → 임금 블록 추출·음수 결측코드 NA·통합변수명 리네임 |
| 61 | 61_wage9_analysis.R | 본분석(A안 Post-LASSO·B안 위계·다중분할 50회) |
| 70 / 70b | 70_desc_table1_w9.R / 70b_valid_n.R | 표1 기술통계 / 항목별 유효 N |
| 71 | 71_robustness_w9.R | 강건성·표본민감도(S1·S2)·생존율 임계 |
| 72 / 83 | 72_heckman_w9.R / 83_heckman_full.R | Heckman 10변수 / 12변수 사양 |
| 73 / 91 / 96 | 73_ses_gradient_w9.R / 91_ses_gradient_ext.R / 96_ses_missing_sens.R | SES 기울기, 형성 단계 확장, 결측 다중대체 민감도 |
| 74 / 97 | 74_figures_w9.R / 97_fig2_w9only.R | [그림 1] / [그림 2] 9차 단독판 |
| 75 | 75_weighted_sens_w9.R | Y25_WEIGHT 가중 민감도 |
| 80 | 80_noleak_check.R | 무누수 검증 R²·50회 분포 |
| 81 / 82 | 81_gender_parent_sens.R / 82_m3_retag.R | 성별·부모학력 추가통제 / M3 재태깅 |
| 85 / 86 / 87 | 85_hourly_robust.R / 86_track_dummy.R / 87_mice_pooled.R | 시간당 임금 / 이과 더미 / MICE m=20 Rubin 합동 |
| 88 / 89 | 88_postselection_infer.R / 89_block_wald_retag.R | BH-FDR·Meinshausen 집계 / 블록 결합 Wald |
| 90 / 92 / 93 | 90_rq3_robust.R / 92_selection_ext.R / 93_downsample.R | RQ3 부트스트랩 500회 / Oster·경력·성별 구성 / 하향추출 |
| 94 / 95 | 94_paneldiff_test.R / 95_oster_sens.R | 계수차 검정 / Oster Rmax 민감도 |
| 98 / 99 | 98_selection_diagnostics.R / 99_archive_console_values.R | 선택 진단(IPW 포함) / 콘솔 전용 수치 보관 |
산출 파일 중 같은 지표에 값이 둘 이상 존재하는 경우(재태깅 ΔR², 안정 변수 개수, 검증 R² 사양별 값)의 정본 표시는 결과_9차/README_산출물_정본표시.md에 있습니다.
재현: 시드 2026 · 스크립트는 요청 시 제공
가나다·알파벳 순입니다. 본문에 점선이 그어진 낱말을 누르면 같은 설명이 아래에서 열립니다.
표 목록
| 표 | 제목 |
|---|---|
| 〈표 1〉 | 표본의 일반적 특성 (임금 상·하위 집단 비교, N=2,022) |
| 〈표 2〉 | A안 Post-LASSO 선택 변수의 전체표본 집락 보정 회귀 (선택후 추론, p<.05) |
| 〈표 3〉 | B안 위계적 선형회귀 모형 적합도 (복합표본) |
| 〈표 4〉 | 다중분할 50회 안정 선택 변수 (생존율 ≥60%) |
| 〈표 5〉 | 청년기 임금의 고교 삼중 관문 통과 요인 |
| 〈표 6〉 | 강건성·가중·선택편향 점검 요약 |
| 〈표 7〉 | 검증 통과 사교육 및 능력·구조 신호의 부모 SES 기울기 |
사이트 주) 아래 표 1~7은 논문 정본의 마크업을 캡션과 주까지 그대로 옮긴 것입니다. 표 주는 논문 원문 그대로입니다. 〈표 4〉의 안정 변수 18개와 〈표 6〉 다중분할 행의 17개 차이는 윈저화 기준집단(주 분석=9차 전일제 전체, 강건성=일반계고 한정) 차이입니다.
〈표 1〉 표본의 일반적 특성
| 특성 | 전체 | 하위임금(n=978) | 상위임금(n=1,044) | 검정 | p |
|---|---|---|---|---|---|
| 월임금(만원) | 283.9(76.1) | 229.3 | 335.0 | — | 분할 기준 |
| 로그 월임금 | 5.62(0.24) | 5.43 | 5.80 | — | 분할 기준 |
| 고3 내신 평균(1~9등급) | 3.98(1.46) | 4.21 | 3.77 | t=−6.68 | <.001 |
| 고3 영어 내신(1~9등급) | 3.99(1.72) | 4.24 | 3.75 | t=−6.24 | <.001 |
| 중3 성적(1~9등급) | 3.85(1.76) | 4.12 | 3.60 | t=−6.70 | <.001 |
| 월평균 사교육비(10만원) | 4.44(3.09) | 4.20 | 4.65 | t=2.85 | .004 |
| 남성 | 41.3% | 36.3% | 46.0% | χ²=19.11 | <.001 |
| 수도권 거주 | 44.7% | 40.6% | 48.6% | χ²=12.42 | <.001 |
| 자연계열(이과) 비율 | 45.4% | 37.3% | 52.9% | χ²=48.66 | <.001 |
| 과학 과외·학원 경험 | 11.5% | 7.6% | 15.1% | χ²=22.83 | <.001 |
| 과학 학습지·통신과외 경험 | 10.7% | 7.3% | 13.7% | χ²=17.79 | <.001 |
| 진로동아리 경험 | 34.8% | 35.9% | 33.8% | χ²=0.85 | .357 |
주) 임금 집단은 로그 월임금 중위수 이상을 상위임금으로 분할(만원 단위 동점값이 많아 상·하위 인원이 다소 비대칭). 내신·중3 성적 등급은 1=최상~9=최하. 자연계열=이과(전체 문과 1,067·이과 917·예체능 37·직업 1). 유효 응답 수는 항목별로 달라 월평균 사교육비 1,545·과학 사교육 1,717·고3 영어 내신 1,927·고3 내신 평균 1,932·수도권 1,945명이다. 연속형 t검정·이분형 χ²검정(집락 미반영 단순검정). 비가중. 자료: KEEP II 1~9차.
〈표 2〉 A안 Post-LASSO 선택 변수
| 변수 (설문 문항) | β | SE | t | p |
|---|---|---|---|---|
| 성별 (L08G104001) | −.036 | .011 | −3.20 | .0016 |
| 수도권 거주 (is_Capital) | +.030 | .011 | 2.84 | .005 |
| 여가-TV·영화 빈도 (L08L101003) | −.013 | .005 | −2.77 | .006 |
| 미술 좋아함 (L08H102058) | −.013 | .005 | −2.73 | .007 |
| 과학 자신감 (L08H102048) | +.015 | .006 | 2.55 | .012 |
| 흡연 경험 (L08G102023) | −.072 | .028 | −2.53 | .012 |
| [과학] 과외·학원 경험 (L08H104018) | −.046 | .018 | −2.50 | .013 |
| 고교 계열(문과/이과) (L08H101009) | +.028 | .012 | 2.40 | .017 |
| 공부 이유-돈 (L08H103016) | +.012 | .005 | 2.34 | .021 |
| 중3 성적등급 (L08H102153) | −.009 | .004 | −2.30 | .022 |
| 고3 영어 내신등급 (L08H102067) | −.010 | .004 | −2.29 | .023 |
| 여가-집안일 빈도 (L08L101012) | −.011 | .005 | −2.27 | .025 |
| 음악 좋아함 (L08H102055) | −.012 | .005 | −2.24 | .026 |
| 고3 수학 내신등급 (L08H102066) | −.009 | .004 | −2.17 | .031 |
| 진로질문-정보판별 (L08H102131) | +.013 | .006 | 2.06 | .041 |
| [과학] 학습지·통신과외 경험 (L08H104019) | −.039 | .019 | −2.05 | .042 |
주) β는 로그 월임금 회귀계수. 코딩: 사교육·흡연 1=있음·2=없음(β<0=경험할수록 임금↑), 내신·중3 성적 1=최상~9=최하(β<0=성적 우수), 계열 1=문과·2=이과(β>0=이과), 성별 1=남·2=여(β<0=여성↓), 5점 척도는 점수가 높을수록 해당 경향. 유의도 주의: 표의 R²(.085)는 독립 검증표본 성능이나 위 계수·p값은 변수선택 표본을 포함한 전체 표본(N=2,022)의 선택후 추정치로 산출 표본이 다르다. p값은 선택후추론 값이라 명목 유의수준을 보장하지 못하며(Berk et al., 2013; Lee et al., 2016), 다중비교를 보정하면(Bonferroni .05/23≈.0022; 분모 23=정제 후 선택 변수 수) 성별(p=.0016) 외에는 임계를 넘지 못한다. 따라서 p값은 탐색적 강도 지표일 뿐, 변수의 무게는 50회 다중분할 생존율(<표 4>)과 교차검증 동시 통과(<표 5>)로 평가한다. 참고용 관대 보정(선택 23변수 naive p의 Benjamini & Hochberg(1995) 절차; 선택 이벤트 미조건화라 유효 FDR은 아님)에서는 삼중 관문 4개가 q<.05·통신과외만 q=.060이었으나, 50회 분할을 결합한 Meinshausen 집계 p(Meinshausen et al., 2009)는 전 변수 1.00이었다. 이 집계는 회차마다 훈련표본 λ.min LASSO 선택 변수를 검증표본 집락 회귀로 재추정한 p를 선택집합 크기(평균 43개)로 Bonferroni 보정한 뒤(미선택 변수 p=1) γ-적응 분위(γ∈[.05,1], 보정계수 1−log.05≈4)로 합친다. 그 회차별 통과율(2~26%)은 <표 4> 생존율(60~94%)과 다른 지표로, 후자는 LASSO 선택만 세나 전자는 검증표본 보정 유의(p<1/|선택집합|≈.023)까지 요구한다. 곧 집계 p=1.00은 신호 부재의 확증이 아니라 이중 조건·보정계수 4의 초보수성이 낳은 산물일 수 있어, 관대한 보정에선 보존되나 엄격한 집계에선 미치지 못하는 삼중 관문의 지위는 탐색적 안정 신호다. 자료: KEEP II 1~9차.
〈표 3〉 B안 위계적 선형회귀 모형 적합도
| 모형 | 투입 변수(개) | R² | 수정 R² | ΔR² |
|---|---|---|---|---|
| M1 성취·투자 | 17 | .064 | .056 | .064 |
| M2 +제도 | 44 | .083 | .063 | .019 |
| M3 +학생참여 | 71 | .118 | .086 | .035 |
| M4 +가족 배경·지역 | 89 | .146 | .107 | .028 |
| 재태깅 (보호자 양육 4문항을 M3→가족 배경으로 재귀속, MICE 동일) | ||||
| M3′ 순수 학생참여 | 67 | .113 | .082 | .030 |
| M4′ 확장 가족 배경·지역 | 89 | .146 | .107 | .034 |
주) 종속변수 로그 월임금. ΔR²는 직전 모형 대비 증분. M3(참여) 블록에는 보호자 양육 문항 4개가 혼입되어 '학생 참여의 효과'로 단정할 수 없으며, 재귀속하면 최대 증분이 확장 가족 배경(M4′)으로 이동하나 양육 제외 위계·부트스트랩 CI로는 판별이 유보된다(수치·검정은 Ⅳ.3). M4의 유의 변수는 과학 통신과외·과학 과외·학원·계열·수도권·예체능 과외·학원이며, 부모 학력·소득은 예측변수 풀·소득 결측으로 미투입(≠비유의), 내신·중3 성적은 M1 변수로 SES 지표가 아니다. 자료: KEEP II 1~9차.
〈표 4〉 다중분할 50회 안정 선택 변수
| 변수 (설문 문항) | 생존율 | 변수 (설문 문항) | 생존율 |
|---|---|---|---|
| 과학 자신감 (L08H102048) | 94% | [과학] 과외·학원 경험 (L08H104018) | 94% |
| 고교 계열(문과/이과) (L08H101009) | 92% | 주말 자기주도 학습시간 (L08H103026) | 92% |
| 고3 영어 내신등급 (L08H102067) | 86% | 중3 성적등급 (L08H102153) | 86% |
| 고3 수학 내신등급 (L08H102066) | 80% | 고3 과학 내신등급 (L08H102068) | 78% |
| 수도권 거주 (is_Capital) | 76% | 성별 (L08G104001) | 74% |
| [예체능] 과외·학원 경험 (L08H104030) | 74% | 여가-집안일 빈도 (L08L101012) | 74% |
| 여가-TV·영화 빈도 (L08L101003) | 72% | [과학] 학습지·통신과외 (L08H104019) | 70% |
| 수학-잘한다 (L08H102042) | 66% | 흡연 경험 (L08G102023) | 60% |
| 고교시설-운동장/체육 (L08H102003) | 60% | [과학] 방과후학교 (L08H104020) | 60% |
주) 학교 단위 50회 다중분할에서 LASSO가 선택한 빈도(생존율 ≥60% 안정). 자료: KEEP II 1~9차.
〈표 5〉 삼중 관문 통과 요인
| 실제 설문 문항 (변수코드) | 척도 | β (A안 / B안 M4) | 생존율 |
|---|---|---|---|
| [과학] 과외·학원 경험 (L08H104018) | 유/무 | −.046* / −.045* | 94% |
| 고교 계열(문과/이과) (L08H101009) | 1문~4직 | +.028* / +.034** | 92% |
| 중3 성적등급 (L08H102153) | 9등급 | −.009* / −.011* | 86% |
| 수도권 거주 (is_Capital) | 더미 | +.030** / +.033** | 76% |
| [과학] 학습지·통신과외 (L08H104019) | 유/무 | −.039* / −.054** | 70% |
| 고3 영어 내신등급 (L08H102067) 〔참고〕 | 9등급 | −.010* / −.012(p=.060) | 86% |
주) β는 로그 월임금 회귀계수(A안 Post-LASSO / B안 위계 M4). 유의도 * p<.05, ** p<.01(별표 없음=비유의). 코딩 방향은 <표 2> 주와 같다(경험 1=있음·2=없음, 등급 1=최상, 계열 β>0=이과). 계열은 1문과~4직업 선형 코딩(예체능·직업 38명, 1.9%)이며 이과 더미(기준 문과)로 재코딩해도 유의하여(단순모형 β=.072·M4 β=.059, p<.001) 실체는 '이과>문과'이다. 생존율은 50회 다중분할 선택 빈도(≥60% 안정). 상단 5개가 삼중 관문 통과 변수이며, 중3 성적은 가중·시간당 임금 사양에서 흔들려 '조건부'로 본다(Ⅳ.5·Ⅴ.1). 하단은 참고 변수. 자료: KEEP II 1~9차.
〈표 6〉 강건성·가중·선택편향 점검 요약
| 점검 | 설정 | 결과 |
|---|---|---|
| 결측 대체 | MICE(주분석, m=1) / 중앙값 / 다중대체 m=20·Rubin 합동 | 검증표본 R² .085 / .087(동일 수준); m=20 합동에서도 핵심 5변수+성별 유의(영어 내신만 p=.18) |
| 벌점 강도 | λ.min(MICE) / λ.1se(중앙값) | 선택 24개·R² .085 / 선택 8개·R² .040 |
| 다중분할 기준 | 생존율 50/60/70% | 안정변수 29/17/14개; 삼중 관문 5변수 모두 생존 |
| 표본정의 | 전체 취업자 S1(N=2,227) / 전일제 S2(N=2,022, 본 분석) | 검증 R² .017 / .087(시간교란 회피 표본정의로 S2 채택) |
| 가중 민감도 | Y25_WEIGHT 적용(단순 6변수) | 6개 항목 방향 6/6·유의 5/6 일치(중3 성적만 가중 시 비유의); 과학 사교육 2종은 가중·비가중 모두 유의 |
| 선택편향 | Heckman 2단계(N=3,978, 선택 50.8%) | 10변수 λ=+.180(p=.877)·핵심 비유의 ↔ 12변수 λ=−.938(p=.398)·과외 .007·통신 .042·계열 .004·수도권 .040 유의. λ 부호까지 사양 의존 → 비식별, 판단 보류 |
| 미관측 교란 | Oster(2019) δ (Rmax=1.3R̃/2R̃/3R̃) | 1.3R̃에서 과외 4.33·통신 3.52·계열 3.29(δ≫1) → 2R̃에서 계열 0.99 → 3R̃에서 셋 다 <1. 관례적 Rmax 조건부 |
| 임금 정의 | 시간당 임금(N=2,217) / 월임금+근무시간 통제(N=2,022) | 네 변수(과외·학원·영어·계열·수도권) 유의 유지. 시간당서 통신 p=.050·중3 .052 경계, 근무시간 통제서 6변수 전부 유의 |
| 추가 통제 | +성별 / +부모 학력(2차 회수) | 핵심 계수 불변, 부·모 학력 비유의(부 .235) → 부모 학력 비환원 |
주) 점추정 검증 R²·강건성 점검은 훈련표본 중앙값 대체로 수행했고 주분석(MICE) 결론과 일치한다(주분석 다중분할도 회차별 중앙값 대체다). 대체법에 따라 LASSO 선택집합은 달라지나(MICE 24↔중앙값 32~33개) 검증 R²는 .085↔.087로 유사하다. <표 4>(18개)와 다중분할 행(17개)의 60% 안정변수 차이는 대체법·시드가 아니라(양쪽 훈련표본 중앙값·동일 시드) 윈저화 기준집단 차이(주분석=9차 전일제 전체, 강건성=일반고 한정)로 경계변수 과학 방과후(60%↔58%) 하나가 문턱을 넘나든 결과이며, 삼중 관문 5변수는 양쪽 다 60%를 크게 넘는다. Heckman은 배제제약이 없어 역Mills 비유의를 편향 부재로 볼 수 없고, 표준오차는 집락·생성회귀변수(역Mills) 미보정 OLS 기준이다. 가중은 Y25_WEIGHT 기준이며 패널 마모 보정 종단 가중치는 공개 자료에 없다. 자료: KEEP II 1~9차.
〈표 7〉 부모 SES 기울기
| 형태 / 신호 | SES 지표 | 표본 | 노출 OR(/+1SD) | p |
|---|---|---|---|---|
| 과학 통신과외 (L08H104019) | 부모 학력 | 분석표본 | 1.26 | .006 |
| 과학 통신과외 | 부모 학력 | 전체 코호트 | 1.30 | <.001 |
| 과학 과외·학원 (L08H104018) | 부모 학력 | 분석표본 | 1.31 | .001 |
| 과학 과외·학원 | 부모 학력 | 전체 코호트 | 1.41 | <.001 |
| 과학 과외·학원 | 부 월소득 | 분석표본 | 1.39 | <.001 |
| 과학 과외·학원 | 부 월소득 | 전체 코호트 | 1.53 | <.001 |
| 능력·구조 신호의 형성 단계 부모 학력 기울기 (참고; 무조정 연관) | ||||
| 중3 상위 성적 | 부모 학력 | 분석표본 / 코호트 | 1.42 / 1.33 | <.001 / <.001 |
| 수도권 거주 | 부모 학력 | 분석표본 / 코호트 | 1.16 / 1.20 | .014 / <.001 |
| 이과 계열 | 부모 학력 | 분석표본 / 코호트 | 1.03 / 1.03 | n.s. |
주) 종속=각 과학 사교육 경험(1=있음). 복합표본 로지스틱(집락=학교, 비가중), OR은 표준화 SES +1SD당이며, 서열형 부모 학력을 연속형으로 간주·표준화하였으므로 이 기울기는 서열 간격을 등간으로 가정한 근사다. 부모 학력은 부·모 최종학력 최고치(2차 조사, 결측 부 9.6%·모 7.2%), 부 월소득 결측 25.9%. 전체 코호트 행 유효 N은 부모 학력 4,001·부 월소득 3,196으로(소득 축이 결측으로 작다) 코호트 5,393 전체가 아니다. 넓게 정의한 노출(과외·학원·방과후 포함)의 미약한 기울기와 SES×사교육 상호작용 비유의는 본문 Ⅳ.7 참조. 하단 형성 단계 기울기에서 수도권 분석표본 p=.014는 다중보정(.0125) 미통과·코호트는 통과이며 모두 무조정 연관이다. SES 결측을 다중대체(m=20)로 회수해도 네 추정의 방향이 유지되고 OR은 소폭 상승하였다. 이 기울기 분석의 노출 2종은 임금 삼중 관문 통과를 근거로 사후 선정되어, 분석 자체가 임금 결과에 조건화된 선택 위에 있다(<표 2>와 동일한 후선택 성격). 자료: KEEP II 1~9차.
그림 목록
[그림 1] 코호트의 차수별 전일제 임금근로 관측 비율 추이(3차 이후)
- 파일:
R분석/결과_9차/Figure1_employment_byWave.png - 본문 위치: Ⅲ.1 분석자료 및 대상
- 원문 캡션·자료 표기:
[그림 1] 코호트의 차수별 전일제 임금근로 관측 비율 추이(3차 이후)
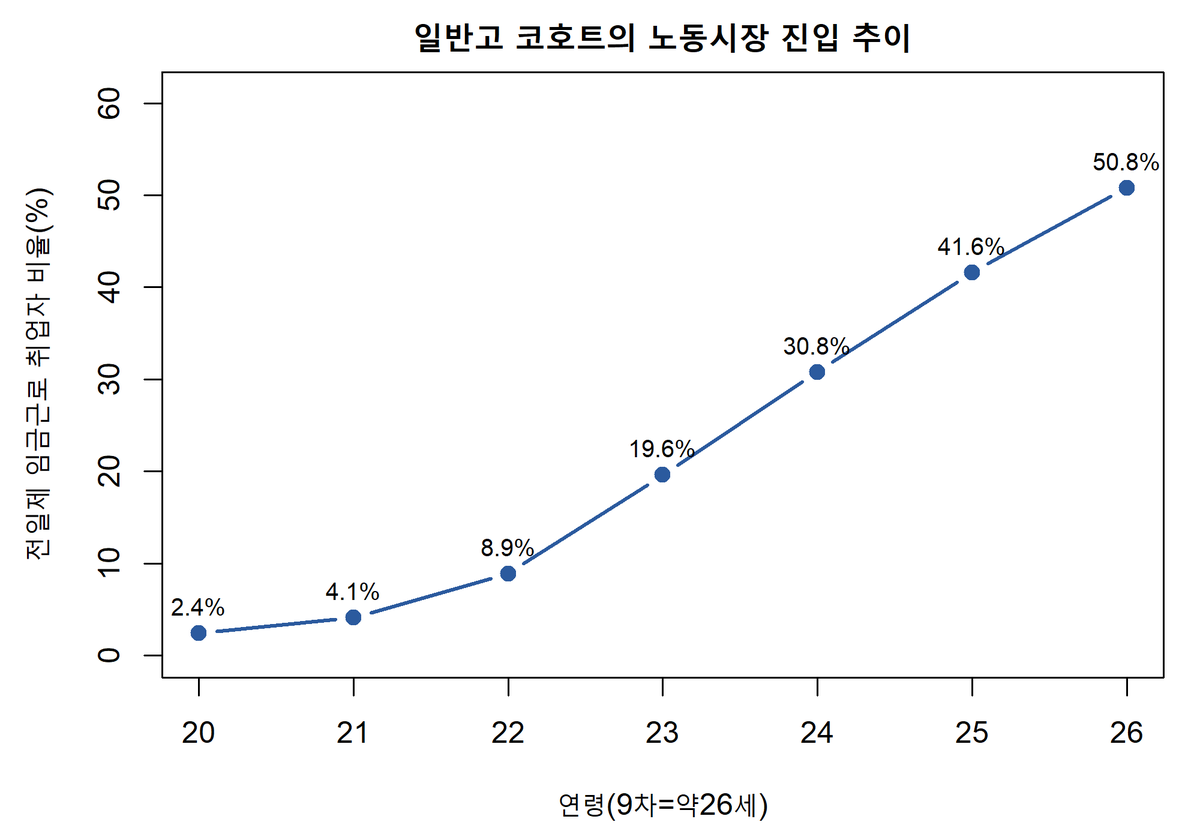
(자료: KEEP II 1~9차. 전일제 임금근로 관측 비율은 9차에 50.8%. 그림은 관측이 시작된 3차(2019)부터. 한글 삽입용 그림 파일: 결과_9차/Figure1_employment_byWave.png)
[그림 2] 위계적 회귀의 영역별 증분 설명력(ΔR²)
- 파일:
R분석/결과_9차/Figure2_hierarchy_dR2_w9only.png(9차 단독판, 생성 스크립트97_fig2_w9only.R) - 본문 위치: Ⅳ.3 B안 위계적 회귀 결과
- 값: M1 .064 · M2 .019 · M3 .035 · M4 .028
- 원문 캡션·자료 표기:
[그림 2] 위계적 회귀의 영역별 증분 설명력(ΔR²)
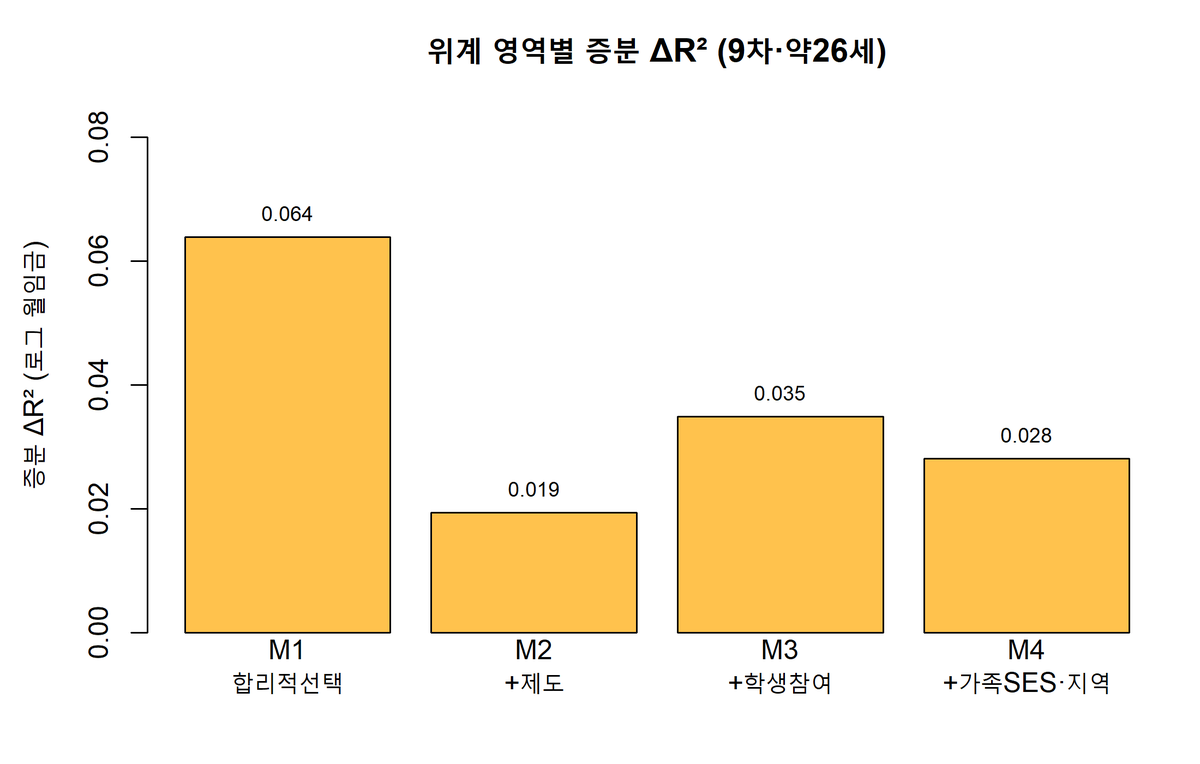
(자료: KEEP II 1~9차. M1 .064·M2 .019·M3 .035·M4 .028. M3·M4 증분 차이는 근소하며, 양육 재태깅 시 최대 증분이 가족 배경으로 이동하나 M3·M4 판별은 유보한다(Ⅳ.3). 한글 삽입용 그림 파일: 결과_9차/Figure2_hierarchy_dR2_w9only.png)
부록 그림 (본문 미수록, 산출물로만 존재)
| 파일 | 내용 |
|---|---|
결과_9차/Figure_LASSO_CV.png | LASSO 10겹 교차검증 오차 곡선(U자). λ.min 지점 표시 |
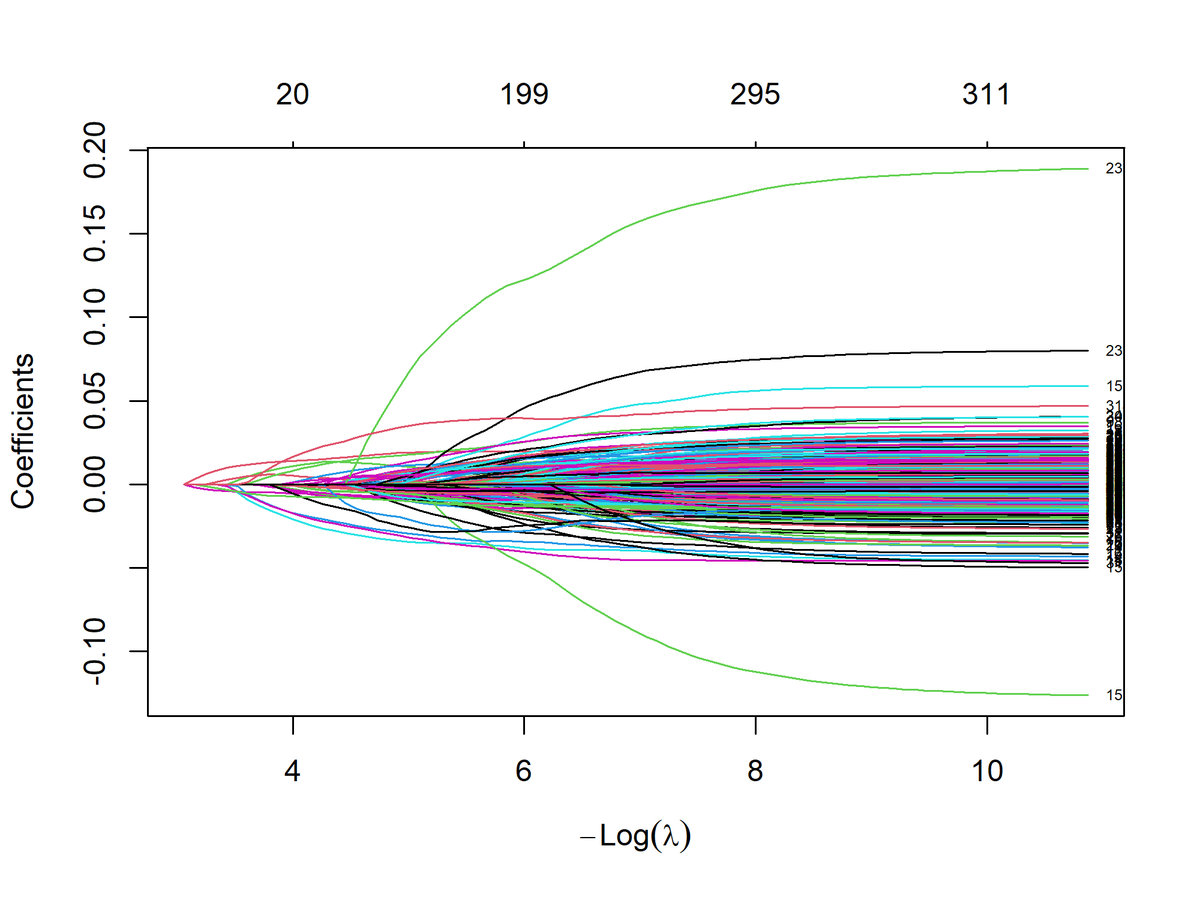
결과_9차/Figure_LASSO_Path.png | LASSO 계수 경로(λ가 줄어들며 계수가 0에서 풀려 나오는 궤적) |
결과_9차/Figure2_hierarchy_dR2.png | ΔR² 구판(9차 단독판 이전 버전). 발표에는 _w9only 쪽을 쓸 것 |
주의: 발표 자료에 넣을 [그림 2]는 반드시 Figure2_hierarchy_dR2_w9only.png(9차 단독판)입니다.
변수 코드 ↔ 설문 문항
표에 나오는 변수 코드가 실제로 어떤 설문 문항이었는지, 응답 보기는 무엇이었는지를 설문지 원문 그대로 옮겼습니다. 표 안의 코드를 눌러도 같은 내용이 열립니다. 설문지 PDF로 확인하지 못한 항목은 코드북 라벨만 싣고 그 사실을 밝혔습니다.
참고문헌 42편
원문 표기를 유지하고, DOI가 있는 항목만 링크로 감쌌습니다. 국문 정기간행물·단행본명은 진하게, 영문 서명·저널명은 이탤릭이 원문 서식입니다.
- 구미령, 유진은(2021). 집단내 상관계수 크기에 따른 벌점회귀 모형의 변수 선택 및 예측 성능 비교: TALIS 2018 자료의 교사 협력 예측 변수 탐색. 아시아교육연구, 22(1), 31–59.
- 김창환, 오병돈(2019). 경력단절 이전 여성은 차별받지 않는가?: 대졸 20대 청년층의 졸업 직후 성별 소득격차 분석. 한국사회학, 53(1), 167–204. https://doi.org/10.21562/kjs.2019.02.53.1.167
- 김희삼(2010). 학업성취도, 진학 및 노동시장 성과에 대한 사교육의 효과 분석. 한국개발연구원 연구보고서 2010-05.
- 박소영, 김지연(2016). 대입 전형 간소화 정책 이후 한국 고등학생의 대학입학 준비 과정. 교육행정학연구, 34(5), 69–95.
- 변수용, 김경근(2010). 한국사회 고등교육 계층화의 영향요인 분석: 일반계 고등학교 졸업생을 중심으로. 교육사회학연구, 20(1), 73–102. https://doi.org/10.32465/ksocio.2010.20.1.004
- 오소욱, 이다인, 공민정(2023). 청년층 초기 일자리의 시퀀스 특성이 경력정착기 노동시장 성과에 미치는 영향. 직업능력개발연구, 26(3), 135–171.
- 오욱환(2000). 한국사회의 교육열: 기원과 심화. 교육과학사.
- 윤민종(2021). 사교육은 "수시" 탓: 대학 입학 전형에 따른 사교육비 차이 탐색. 교육학연구, 59(6), 215–238.
- 이경희, 김태일(2007). 대학순위와 전공의 임금효과. 교육학연구, 45(3), 167–197.
- 이광현, 권용재(2021). 대입제도 쟁점 분석: 수시와 정시 입학생들의 소득수준 비교분석. 한국콘텐츠학회논문지, 21(12), 107–117. https://doi.org/10.5392/JKCA.2021.21.12.107
- 이기혜, 최윤진(2016). 대학입학전형 선발 결정요인 분석: 학생부종합전형을 중심으로. 한국교육학연구, 22(1), 135–163.
- 이기혜, 전하람, 최윤진(2017). 서울시 고교생의 대학입학전형 영향요인 분석. 교육과학연구, 48(3), 77–106.
- 이재성, 백원영, 안준기(2016). 사교육의 장기효과는 존재하는가?: 한국교육고용패널조사를 이용한 분석. 직업능력개발연구, 19(3), 57–84. https://doi.org/10.36907/krivet.2016.19.3.57
- 장미혜(2002). 사회계급의 문화적 재생산: 대학간 위계서열에 따른 부모의 계급구성의 차이. 한국사회학, 36(4), 223–251.
- 장상수(2000). 교육 기회의 불평등: 가족 배경이 학력 성취에 미치는 영향. 한국사회학, 34(가을), 671–708.
- 전병유, 정준호(2020). 소득계층별 대학입시전형 선택과 입학 성과. 동향과 전망, (108), 80–115. https://doi.org/10.22813/kssi.2020..108.80
- 한국직업능력연구원(2026). 한국교육고용패널Ⅱ 9차년도(2025) 조사 사용자 지침서. 한국직업능력연구원.
- Altonji, J. G.(1995). The effects of high school curriculum on education and labor market outcomes. Journal of Human Resources, 30(3), 409–438. https://doi.org/10.2307/146029
- Becker, G. S.(1964). Human Capital: A Theoretical and Empirical Analysis. Columbia University Press.
- Benjamini, Y., & Hochberg, Y.(1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B, 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Berk, R., Brown, L., Buja, A., Zhang, K., & Zhao, L.(2013). Valid post-selection inference. The Annals of Statistics, 41(2), 802–837. https://doi.org/10.1214/12-AOS1077
- Boudon, R.(1974). Education, Opportunity, and Social Inequality. Wiley.
- Bourdieu, P.(1986). The forms of capital. In J. G. Richardson (Ed.), Handbook of Theory and Research for the Sociology of Education (pp. 241–258). Greenwood.
- Bray, M.(1999). The Shadow Education System: Private Tutoring and Its Implications for Planners. UNESCO IIEP.
- Byun, S.(2014). Shadow education and academic success in Republic of Korea. In H. Park & K.-K. Kim (Eds.), Korean Education in Changing Economic and Demographic Contexts (pp. 39–58). Springer.
- Card, D., & Krueger, A. B.(1992). Does school quality matter? Returns to education and the characteristics of public schools in the United States. Journal of Political Economy, 100(1), 1–40. https://doi.org/10.1086/261805
- Friedman, J., Hastie, T., & Tibshirani, R.(2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01
- Heckman, J. J.(1979). Sample selection bias as a specification error. Econometrica, 47(1), 153–161. https://doi.org/10.2307/1912352
- Lareau, A.(2011). Unequal Childhoods: Class, Race, and Family Life (2nd ed.). University of California Press.
- Lee, J. D., Sun, D. L., Sun, Y., & Taylor, J. E.(2016). Exact post-selection inference, with application to the lasso. The Annals of Statistics, 44(3), 907–927. https://doi.org/10.1214/15-AOS1371
- Lucas, S. R.(2001). Effectively maintained inequality: Education transitions, track mobility, and social background effects. American Journal of Sociology, 106(6), 1642–1690. https://doi.org/10.1086/321300
- McNamee, S. J., & Miller, R. K.(2009). The Meritocracy Myth (2nd ed.). Rowman & Littlefield.
- Meinshausen, N., Meier, L., & Bühlmann, P.(2009). p-values for high-dimensional regression. Journal of the American Statistical Association, 104(488), 1671–1681. https://doi.org/10.1198/jasa.2009.tm08647
- Meinshausen, N., & Bühlmann, P.(2010). Stability selection. Journal of the Royal Statistical Society: Series B, 72(4), 417–473. https://doi.org/10.1111/j.1467-9868.2010.00740.x
- Meyer, J. W., & Rowan, B.(1977). Institutionalized organizations: Formal structure as myth and ceremony. American Journal of Sociology, 83(2), 340–363. https://doi.org/10.1086/226550
- Murnane, R. J., Willett, J. B., & Levy, F.(1995). The growing importance of cognitive skills in wage determination. The Review of Economics and Statistics, 77(2), 251–266.
- Oster, E.(2019). Unobservable selection and coefficient stability: Theory and evidence. Journal of Business & Economic Statistics, 37(2), 187–204. https://doi.org/10.1080/07350015.2016.1227711
- Rubin, D. B.(1987). Multiple Imputation for Nonresponse in Surveys. John Wiley & Sons.
- Ryu, D., & Kang, C.(2013). Do private tutoring expenditures raise academic performance? Evidence from middle school students in South Korea. Asian Economic Journal, 27(1), 59–83. https://doi.org/10.1111/asej.12002
- Spence, M.(1973). Job market signaling. Quarterly Journal of Economics, 87(3), 355–374. https://doi.org/10.1093/qje/87.3.355
- Tibshirani, R.(1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B, 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Young, M.(1958). The Rise of the Meritocracy. Thames and Hudson.
DOI 부여 항목은 20편입니다(실측: 참고문헌 42편 중 https://doi.org/ 표기 20건). 나머지는 단행본·연구보고서이거나 DOI가 부여되지 않은 국문 학술지 항목입니다.